Cómo montar un pipeline de IA con loops: mi fábrica de modelos 3D
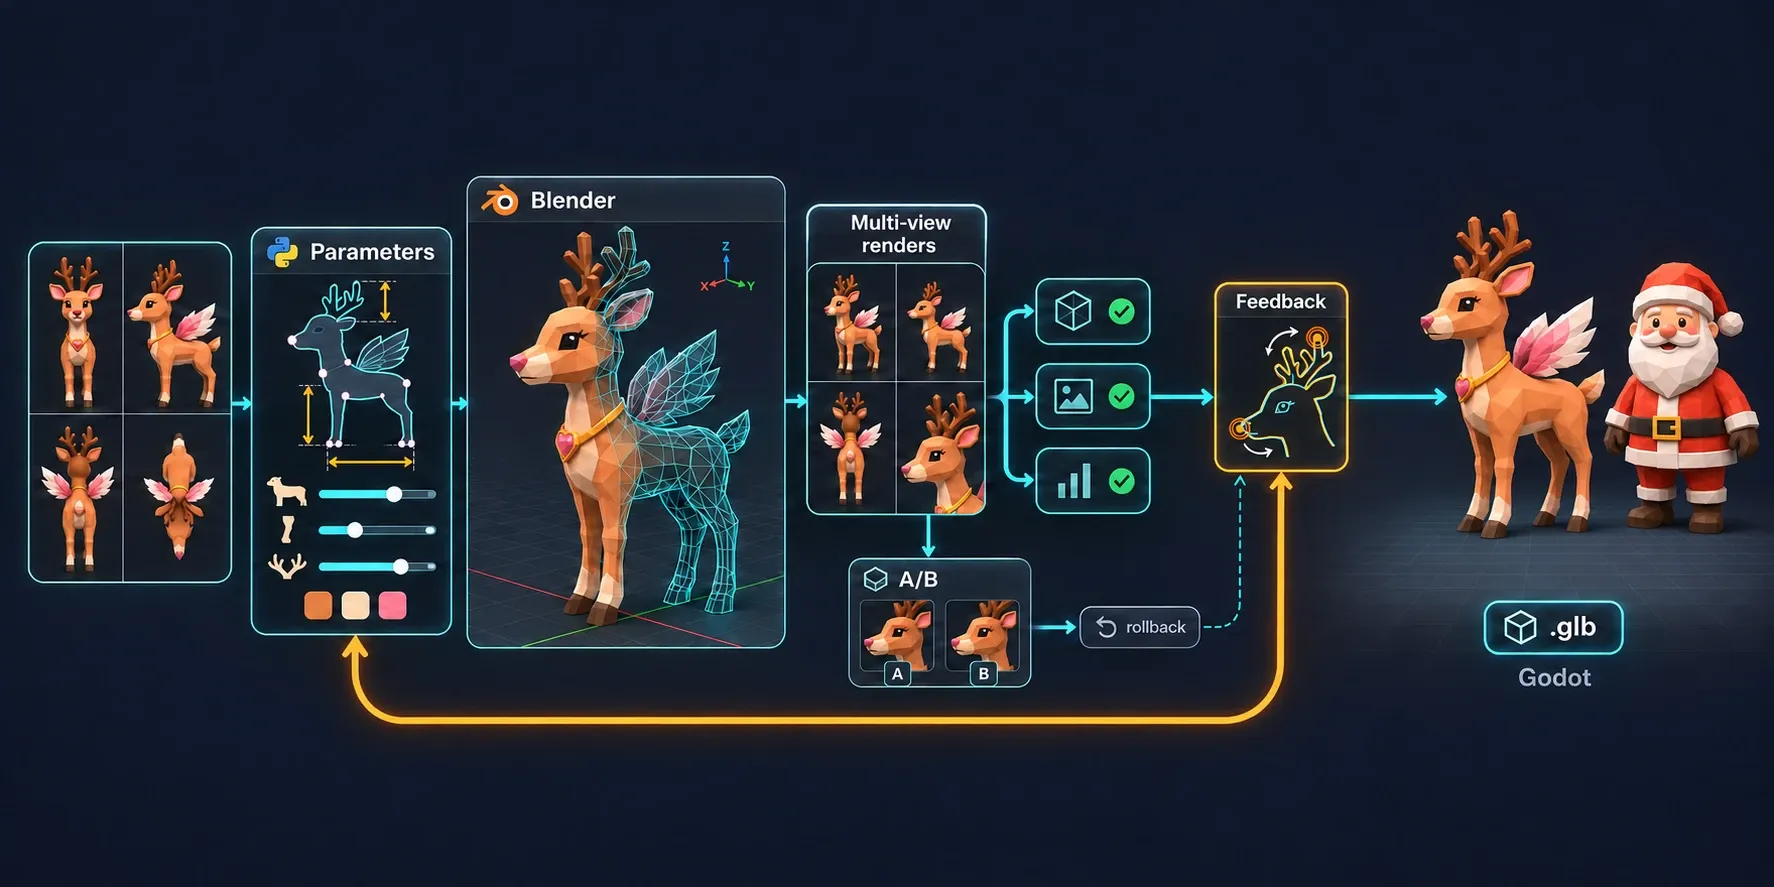
Estoy haciendo Santa Slideway, un juego para móvil hecho entero con IA, modelos 3D incluidos. En el artículo anterior te conté lo que le costó a mi «fábrica de modelos 3D» crear el protagonista: unos 190 $ en IA por un Papá Noel 3D con esqueleto y animaciones.
Aquel artículo iba del coste. Este va de cómo está hecho por dentro: cómo se monta un pipeline de IA con loops. Los pipelines de agentes autónomos que revisan su propio trabajo son hoy el estado del arte de la IA aplicada: es la dirección en la que trabajan las empresas más avanzadas, y Anthropic ha publicado los patrones para montarlos. No hace falta que sepas nada de 3D: lo que te cuento es aplicable también a otros ámbitos.
Las piezas de mi fábrica de modelos 3D
Mi fábrica de modelos 3D es un pipeline de IA autónomo: una cadena de pasos que, una vez arranca, lleva de una entrada a un resultado sin que nadie tenga que intervenir. En mi caso, la entrada son cuatro imágenes de referencia que aporto yo, y el resultado, un personaje 3D animado dentro del juego.
Se pone en marcha a partir de una petición externa. Puedo ser yo desde el chat, pero también podría lanzarlo una tarea programada que se despierta cada noche, o un webhook que llama otro sistema cuando hay imágenes nuevas. Una vez iniciado, el pipeline trabaja solo.
Déjame presentarte primero las piezas del sistema.
Agentes
Anthropic define un agente como un sistema en el que un modelo de IA dirige su propio proceso y el uso de sus herramientas para conseguir un objetivo (Building effective agents (se abre en una pestaña nueva)). En la práctica, un agente trabaja con tres cosas: unas instrucciones (la petición y el contexto del proyecto), un catálogo de herramientas que puede usar y un catálogo de habilidades (o skills), conocimiento adicional que carga solo si la tarea lo pide. Con esos elementos, el agente es capaz de decidir los siguientes pasos sin que nadie se los dicte.
Como nosotros, los agentes trabajan mejor cuando pueden centrar su foco en una tarea concreta, así que cuando el encargo es complejo, lo mejor es repartirlo en subtareas. El agente principal, el que recibe la petición, hace de orquestador: organiza el trabajo y toma las decisiones. Los subagentes son agentes aparte que el orquestador lanza para un encargo concreto. Cada uno trabaja con su propio contexto y solo devuelve un informe corto, así que sus esfuerzos no llenan la memoria del orquestador.
En mi caso, el agente principal es el propio chat de Claude Code: la conversación que abro yo (o la que abriría una tarea programada). Es el único que toca el modelo 3D. Los subagentes revisan, miden o montan vídeos.
Skills
Una skill es una carpeta con instrucciones, scripts y documentos de referencia sobre cómo hacer un trabajo concreto. Lo interesante es cómo se carga. Al empezar, el agente solo ve el nombre y la descripción de cada skill disponible, un par de líneas. Cuando una petición encaja con una descripción, el agente decide cargar esa skill y entonces lee sus instrucciones completas. Así puede tener muchas skills a mano sin pagar el coste de leerlas todas.
En mi caso, he creado una skill para cada loop: una para el modelado, otra para el rigging y otra para el vídeo del proceso.
Loops
Un loop es un ciclo que hace una tarea, comprueba el resultado y se repite hasta cumplir unos criterios. No es un programa aparte: lo define la propia skill. Su archivo principal describe las fases del ciclo y quién hace qué en cada una, y deja claro que el agente no se para hasta cumplir el criterio de terminado.
Un pipeline puede tener pasos de todo tipo, pero en el mío casi todo el trabajo pasa dentro de loops. En mi caso, hay tres: modelado, esqueleto y animación, y un vídeo del proceso.
Criterio de terminado
Es la condición de salida del loop, y también va en la skill. Sin ella, o el loop no termina nunca, o termina cuando al agente le parece que ya está bien, que es justo lo que quieres evitar. Cuanto más medible, mejor.
En mi caso, el criterio del modelado son cifras: cuánto coincide la silueta, a cuántos centímetros quedan los bordes y cuántos fallos siguen abiertos.
Herramientas
Una herramienta es un instrumento al que tiene acceso el agente para realizar una acción: leer y editar archivos, buscar, ejecutar comandos, lanzar subagentes… El modelo decide cuándo usar cada una y el resultado vuelve a su conversación. Cada agente tiene las suyas, con sus permisos: un orquestador puede escribir y ejecutar, y un subagente que solo revisa puede tener permiso solo para leer.
En mi caso, el agente usa las herramientas de serie de Claude Code. La de ejecutar comandos es especialmente relevante, porque es la que permite al agente usar los scripts de la skill para medir la silueta frente al dibujo, el color, la salud de la malla y las articulaciones.
Memoria en disco
La memoria de trabajo de un agente se llena, y cuando se llena se resume y se pierden detalles. Todo lo que el loop tiene que recordar de una vuelta a otra conviene guardarlo en archivos, no en la cabeza del agente. Y los archivos los pueden leer también los subagentes.
En mi caso, eso es un registro de fallos, un documento de medidas y el historial de git.
Modelos y harness
El modelo de IA es el cerebro del agente: la parte que lee, razona, escribe, decide qué hacer y qué herramienta usar. No todos los agentes necesitan el más capaz. Las tareas que piden criterio van a un modelo grande; las mecánicas, a uno más barato.
Pero estos modelos, por sí solos, solo generan texto. El harness es el programa que lo pone a trabajar: le pasa las instrucciones y el contexto, ejecuta las herramientas que el modelo pide y le devuelve el resultado, una y otra vez. También gestiona su memoria, aplica los permisos, lanza los subagentes y carga las skills. Un agente necesita las dos cosas: el modelo, que decide, y el harness, que ejecuta.
Al arrancar cada sesión, el harness prepara el contexto inicial a partir de la carpeta del proyecto:
CLAUDE.md: las instrucciones del proyecto. Se copia entero en cada sesión, así que es el sitio para todo aquello que el agente tiene que saber siempre..claude/skills/: las skills. De entrada, solo se carga el nombre y la descripción de cada una..claude/agents/: un archivo por subagente, con la descripción de su trabajo, las herramientas que puede usar y su modelo..claude/settings.json: qué herramientas puede usar el agente y con qué permisos.
En mi caso, el orquestador y los subagentes que juzgan usan Claude Opus 5.5, y los que hacen tareas más mecánicas, Claude Sonnet 5.5. Como harness uso Claude Code (se abre en una pestaña nueva), el de Anthropic, en su entorno en la nube. Y dentro, Blender (se abre en una pestaña nueva) (el programa de 3D) y Godot (se abre en una pestaña nueva) (el motor del juego), ambos funcionando sin pantalla.
Anatomía de mi pipeline de modelado 3D
Con todas las piezas sobre la mesa, así fluye una petición por mi fábrica, del primer mensaje al resultado:
- Se abre una sesión. Al abrir un chat nuevo, o cuando salta una tarea programada, el harness prepara el contexto inicial: el
CLAUDE.md, la lista de skills, los subagentes disponibles y las herramientas con sus permisos. Ese chat ya es un agente, el agente principal. - Llega la petición: el agente recibe su primer mensaje. Por ejemplo, «modela este personaje a partir de estas cuatro imágenes, ponle esqueleto y animaciones, y mételo en el juego».
- Loop 1, modelado. El agente detecta la skill de modelado y la lee. Desde ese momento hace de orquestador: reparte trabajo a los subagentes, apunta en disco lo que tiene que recordar y sigue trabajando en bucle hasta que cumple el criterio de terminado.
- Loop 2, esqueleto y animación. Con el modelo terminado, el agente sigue sus instrucciones, lee la skill de rigging y pasa al siguiente loop, en este caso sin subagentes.
- Loop 3, vídeo (opcional). Una vez ha salido de los loops de modelado y de animación, y si estaba en la petición inicial, el agente lee la skill de vídeo y entra en un último loop para montar el vídeo del proceso. Utiliza subagentes para revisar que el montaje del vídeo cumple el encargo.
- Entrega. Cuando ha acabado todos los loops, el agente principal mete el personaje dentro del juego.
Un detalle importante: cada skill define su propio loop, pero ninguna llama a la siguiente. Quien encadena los loops es el agente principal.
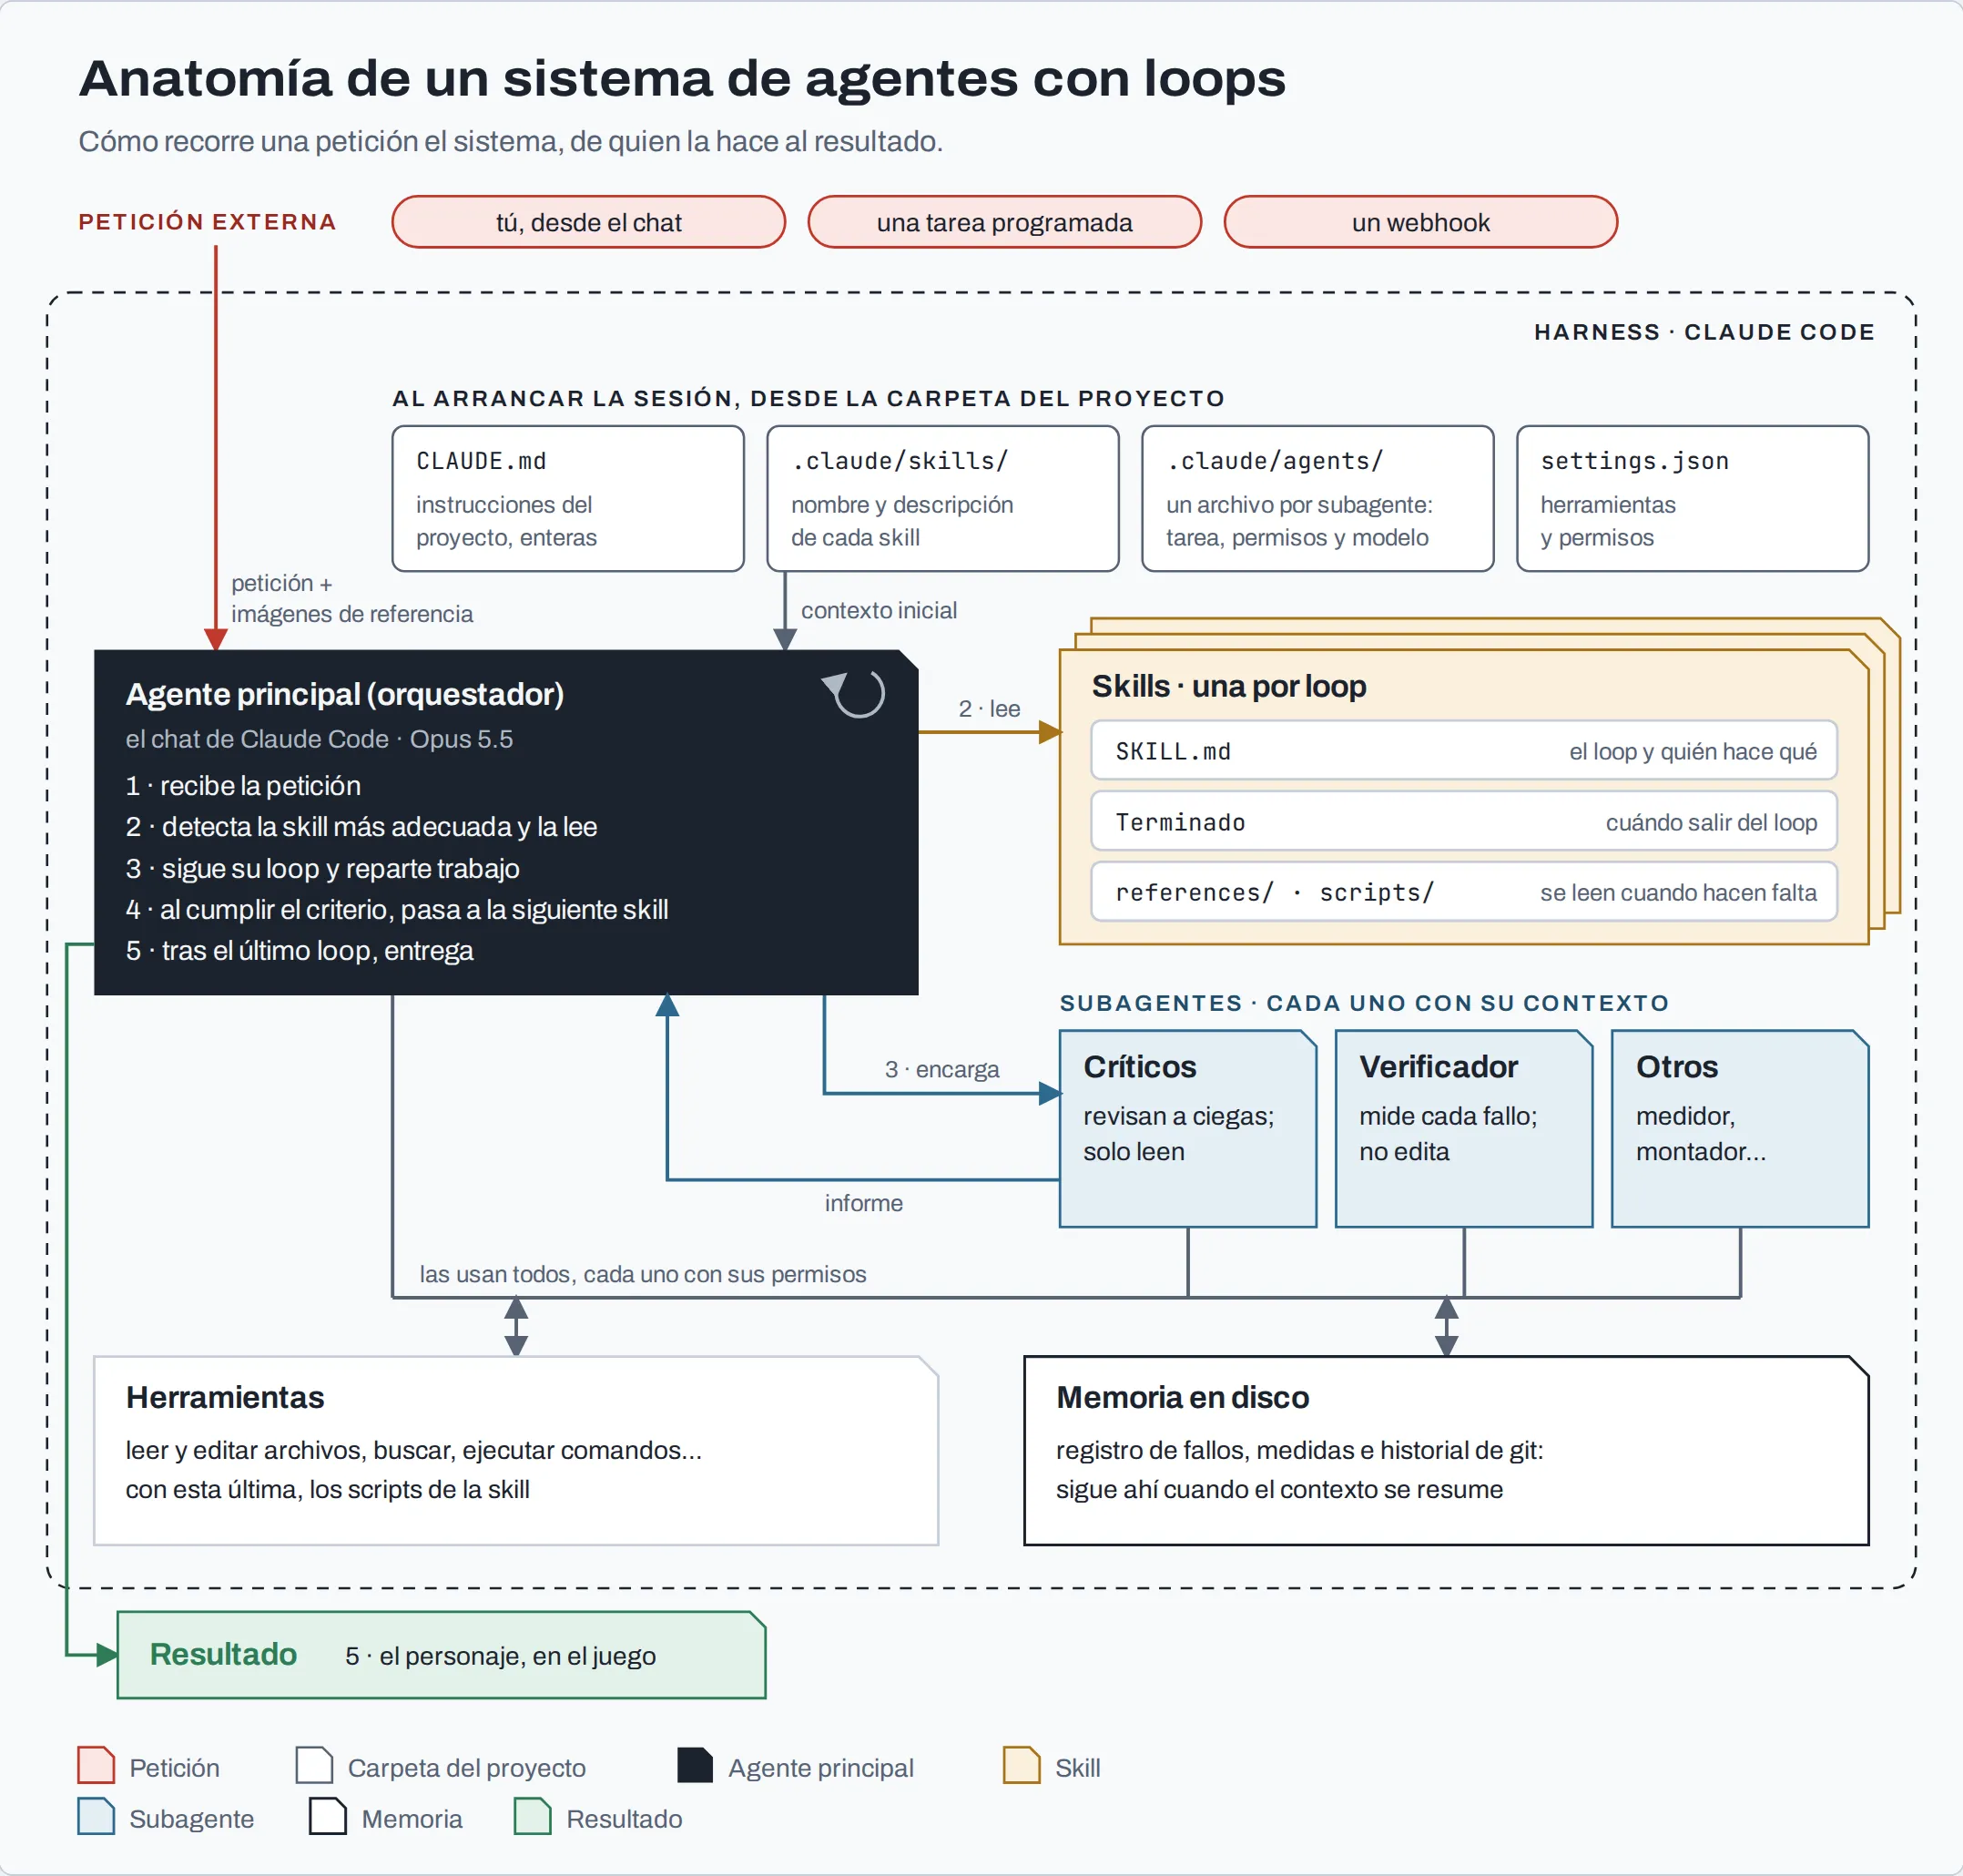
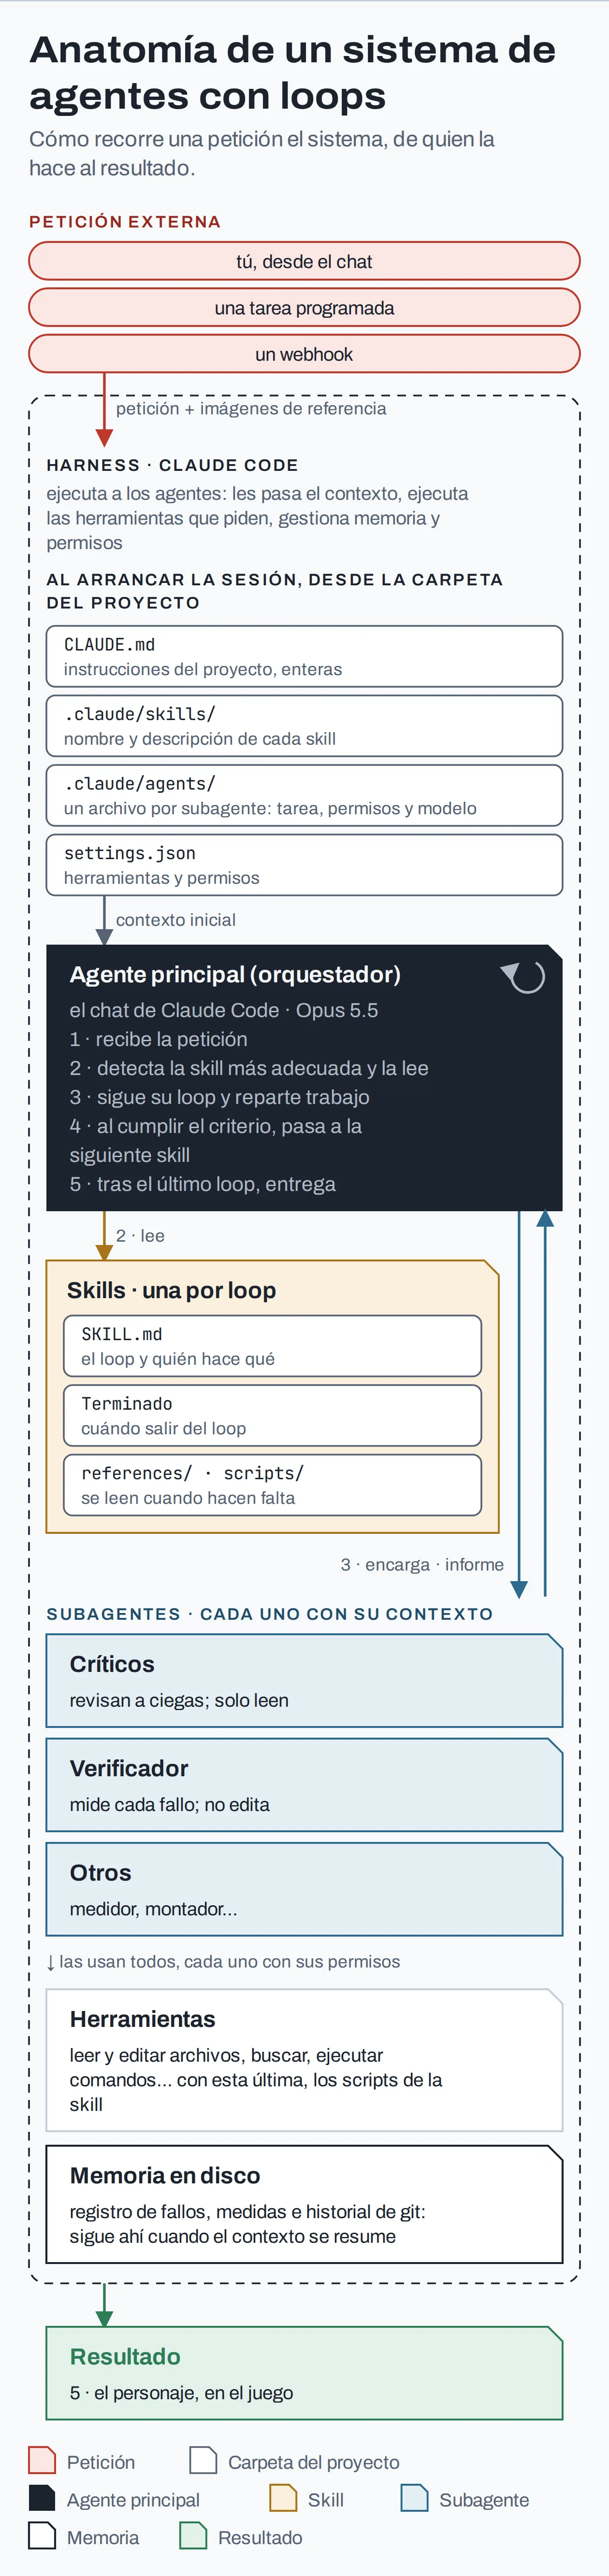 Anatomía de un sistema de agentes con loops
Los patrones de loops de Anthropic
Esto de los loops no es un invento mío. Son una serie de patrones que recomienda Anthropic.
El loop básico de un agente es reunir contexto, actuar, verificar y repetir. Así lo describe Anthropic en Building agents with the Claude Agent SDK (se abre en una pestaña nueva), y añade que, cuando la verificación la puede hacer código, mejor.
Sobre esa base, en Building effective agents (se abre en una pestaña nueva) describe varios patrones para organizar el trabajo. Yo uso tres:
- Evaluador-optimizador: un agente genera el resultado y otro, el evaluador, lo revisa y le dice qué corregir. Se repite hasta que el evaluador lo da por bueno. Es el loop en sí. En mi caso, está en los tres loops, y en el de rig el evaluador no es un agente sino código.
- Orquestador-trabajadores: un agente principal reparte el trabajo entre subagentes y junta sus resultados. Es lo que hace Anthropic en su sistema de investigación multiagente (se abre en una pestaña nueva). En mi caso, lo uso en el modelado y en el vídeo.
- Paralelización por secciones: varios agentes evalúan a la vez, cada uno un aspecto distinto. Esto lo hago en el primer loop, con los tres críticos de modelado.
El pipeline de un vistazo
En mi caso, hay un paso previo que hago a mano a propósito: el diseño. Elijo el aspecto del personaje con ChatGPT (GPT Image 2) y saco cuatro imágenes de referencia en pose T: frente, lado, espalda y arriba. La dirección artística me la quedo yo.
A partir de ahí, tres loops automáticos:
- Modelado.
- Esqueleto y animación (el rig).
- Vídeo del proceso, opcional.
Al final puedo revisarlo en un visor 3D, si quiero.
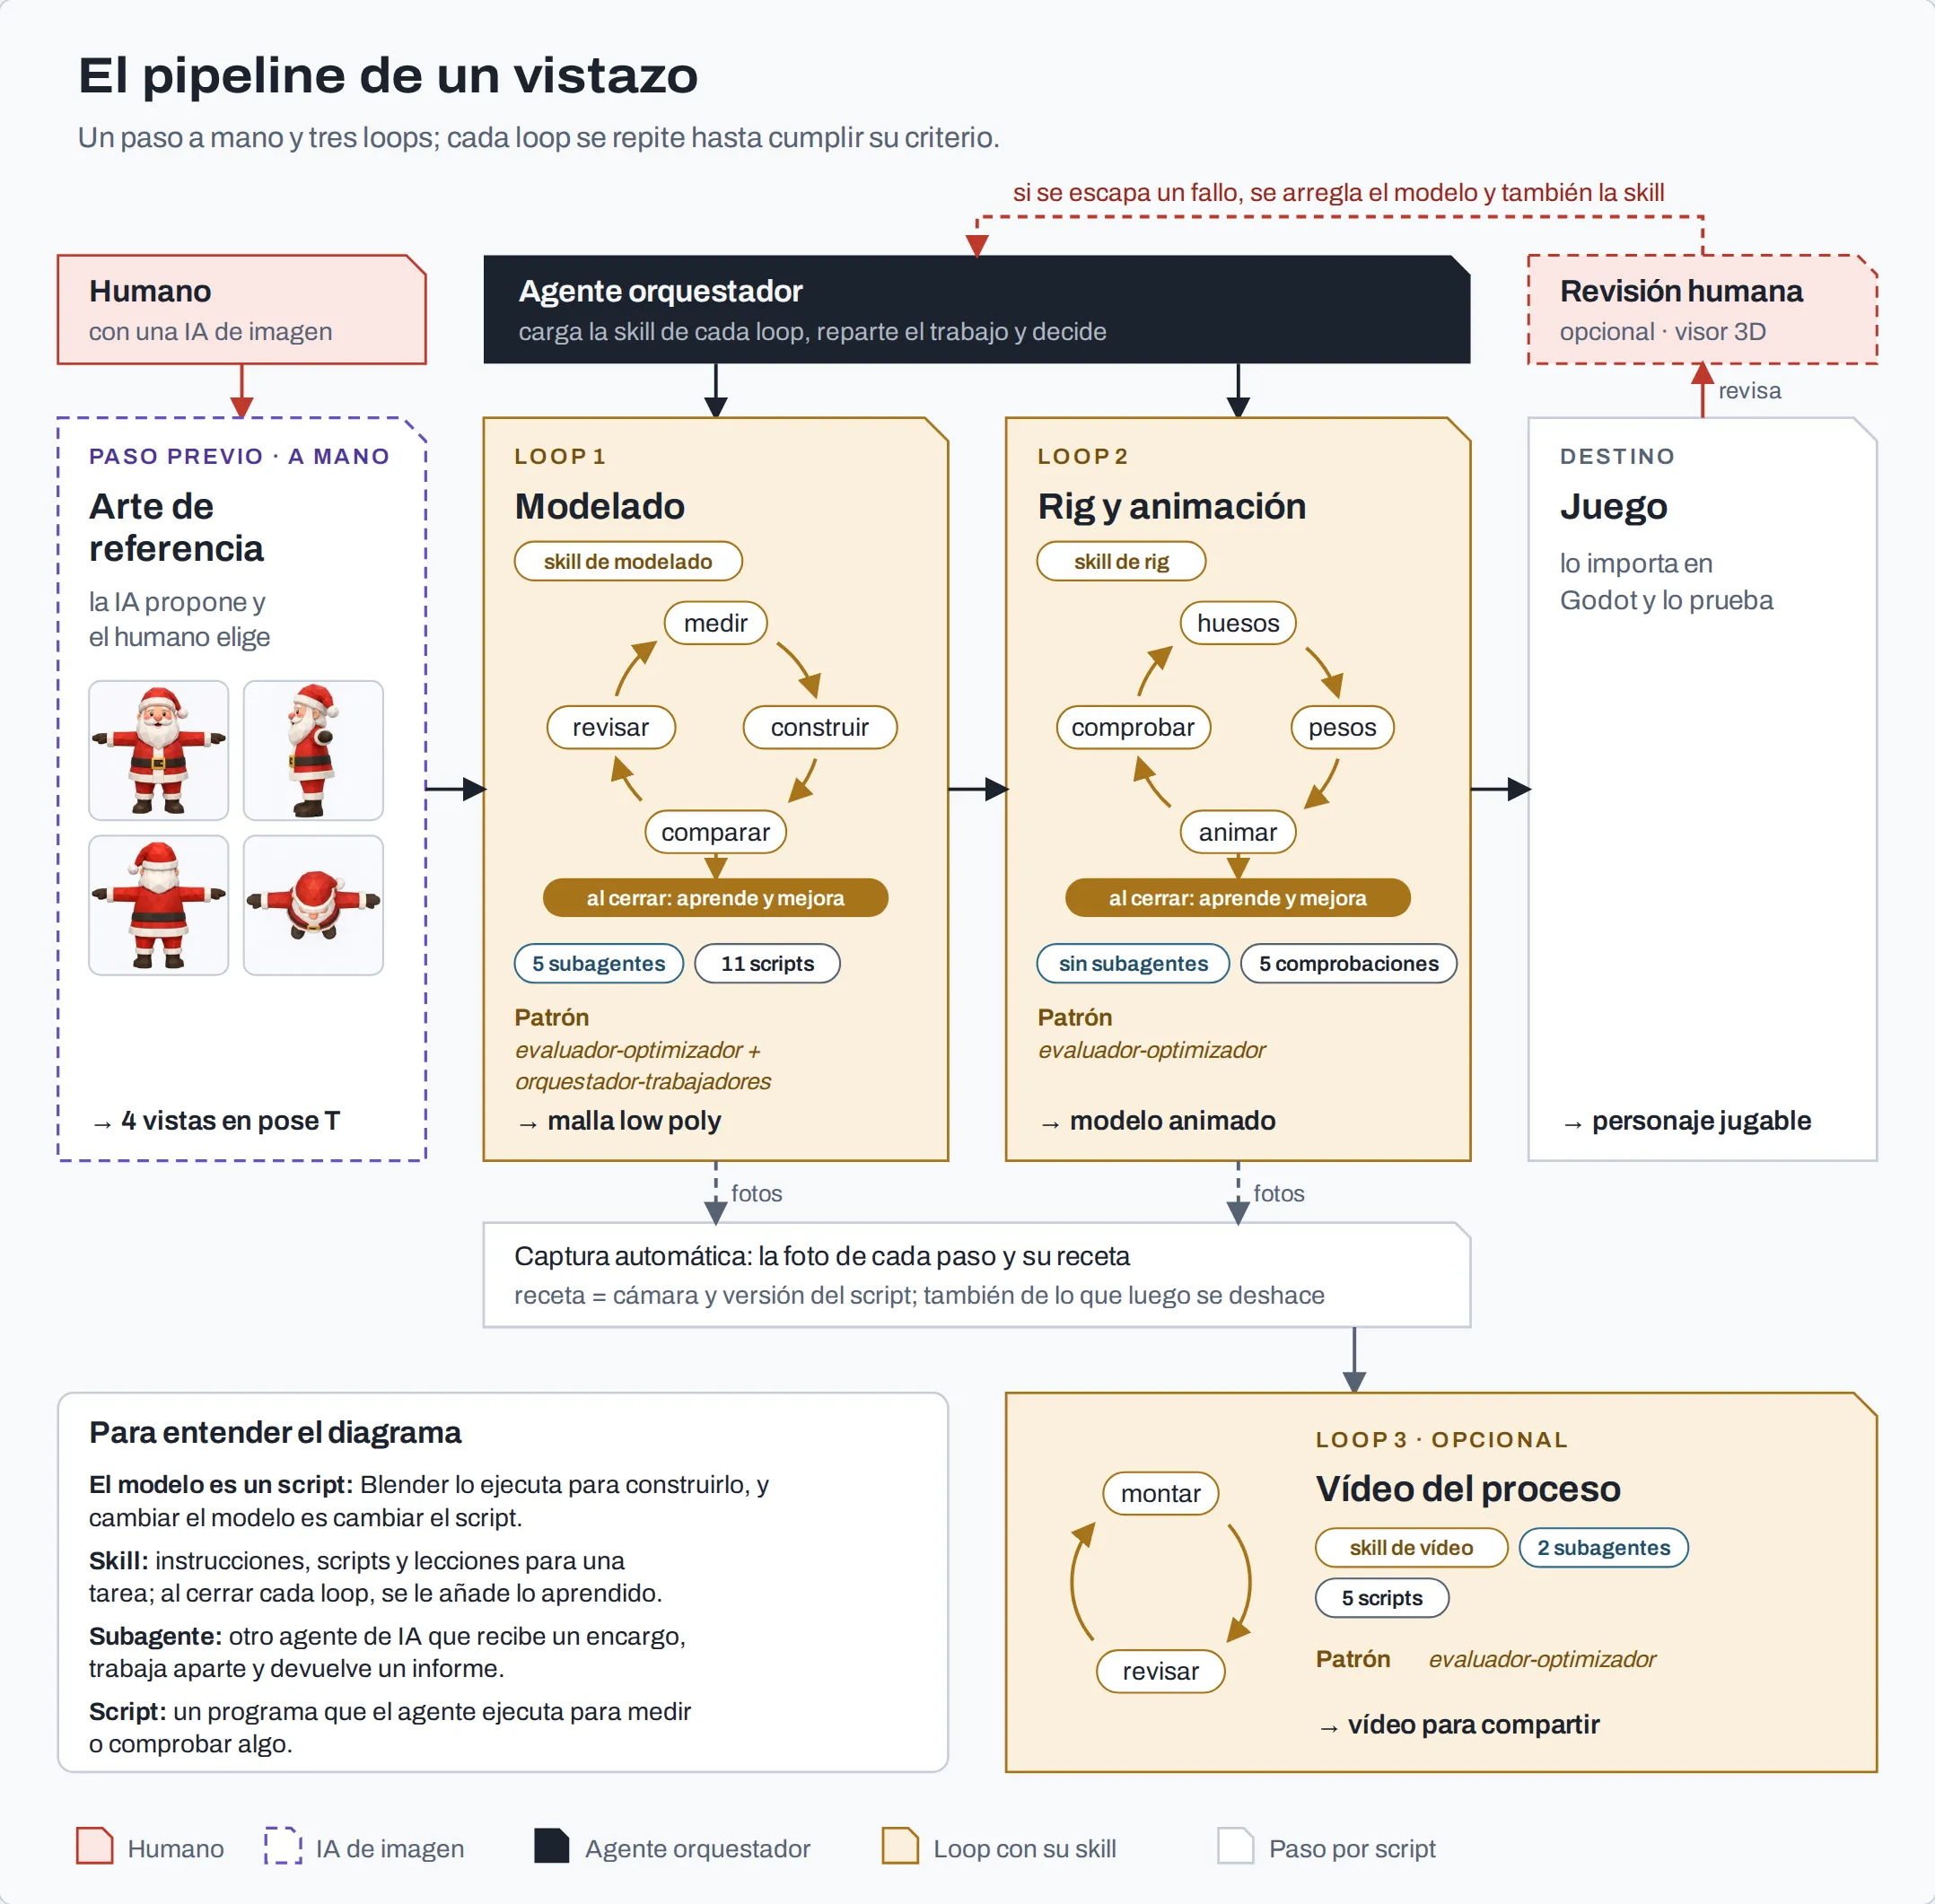
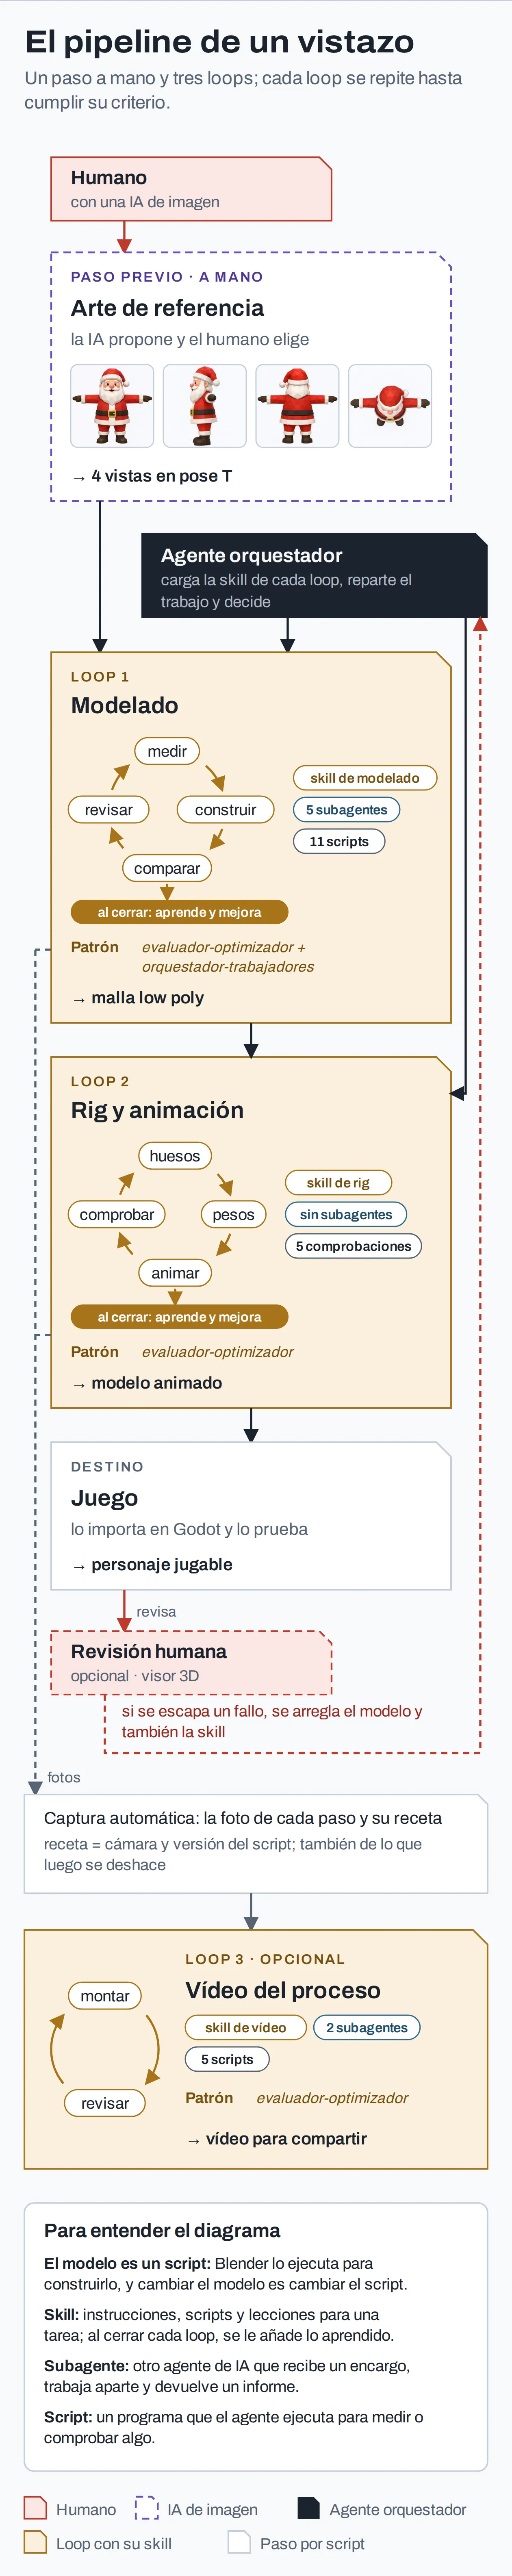 El pipeline de un vistazo
La base: que el trabajo sea código
Una cosa más antes de entrar en los loops. Un agente trabaja mucho mejor cuando lo que produce es texto o código: lo puede leer, cambiar, comparar entre versiones, deshacer y medir. Si tu problema no es código de entrada, merece la pena buscar la forma de que lo sea.
En mi caso, nadie arrastra vértices con el ratón. Cada personaje es código Python que Blender ejecuta sin pantalla, y vive en su propia carpeta del repositorio (scripts/tools/blender/<personaje>/) con dos archivos:
params.py: todas las medidas y los colores del personaje (el alto del gorro, el ancho de la barriga, dónde van los ojos), además de sus luces y cámaras. Ningún número va fuera de este archivo.build.py: qué piezas tiene el personaje y cómo se montan con esas medidas.
Lo que es igual para todos los personajes (la geometría básica, la escena, las cámaras, las medidas y las capturas) está en una librería común dentro de la skill. Así, un personaje nuevo solo necesita sus dos archivos. Al lado vive su registro de fallos, defectos.md.
Con eso, el agente puede cambiar el modelo como cualquier otro código, deshacer versiones con git y medir el resultado, porque cada ejecución sale de los mismos números. Cada paso deja además una captura y la receta para repetirla (la cámara y la versión del script). Así el vídeo del proceso se puede volver a renderizar en más calidad sin repetir el trabajo.
Loop 1: modelado
Es el loop más complejo y el que se lleva casi todo el coste.
Los agentes
En un loop de revisión, lo primero es separar quién hace el trabajo de quién lo juzga. Si el mismo agente construye, decide qué está mal y valora sus propias correcciones, arrastra sus sesgos de una tarea a otra.
En mi caso, el orquestador escribe y corrige el script del modelo. Alrededor tiene seis subagentes:
| Subagente | Qué hace | Herramientas | Modelo |
|---|---|---|---|
| medidor de dibujos | mide las referencias, una vez por personaje | Bash, lectura, escritura | Opus 5.5 |
| crítico de forma | ¿se parece al dibujo? | solo lectura | Opus 5.5 |
| crítico de acabado | busca pinchos, huecos, uniones mal hechas | solo lectura | Opus 5.5 |
| crítico A/B | elige la mejor de dos versiones sin saber cuál es la nueva | solo lectura | Sonnet 5.5 |
| verificador | mide cada fallo que señalan los críticos | Bash y lectura, no edita | Opus 5.5 |
| inspector (opcional) | responde una pregunta concreta sobre una imagen | solo lectura | Sonnet 5.5 |
En Claude Code, cada subagente es un archivo en .claude/agents/<nombre>.md: contiene una cabecera con su nombre, una descripción, las herramientas que puede usar y el modelo, y debajo sus instrucciones. Fíjate en los permisos: los críticos solo pueden leer, y el verificador puede ejecutar scripts pero no tocar el modelo.
Aquí van tres principios que me agradecerás:
- Limita la información al subagente. Pásale rutas y, como mucho, una línea de contexto. Nunca la hipótesis del orquestador: si le cuentas sus sospechas, acabará por confirmarlas aunque no sean ciertas.
- Pídele que lea todo de golpe. Cada lectura que el agente hace por separado es un turno más de conversación, así que el modelo lee de nuevo todo lo que lleva acumulado. Si un subagente tiene que mirar decenas de imágenes, pídele que las lea todas en una sola respuesta, en paralelo. Este planteamiento me permitió reducir el tiempo y el coste de los agentes de crítica.
- Recuerda que los subagentes se cargan al arrancar la sesión. Si cambias o añades uno, tendrás que empezar una nueva sesión para usarlo.
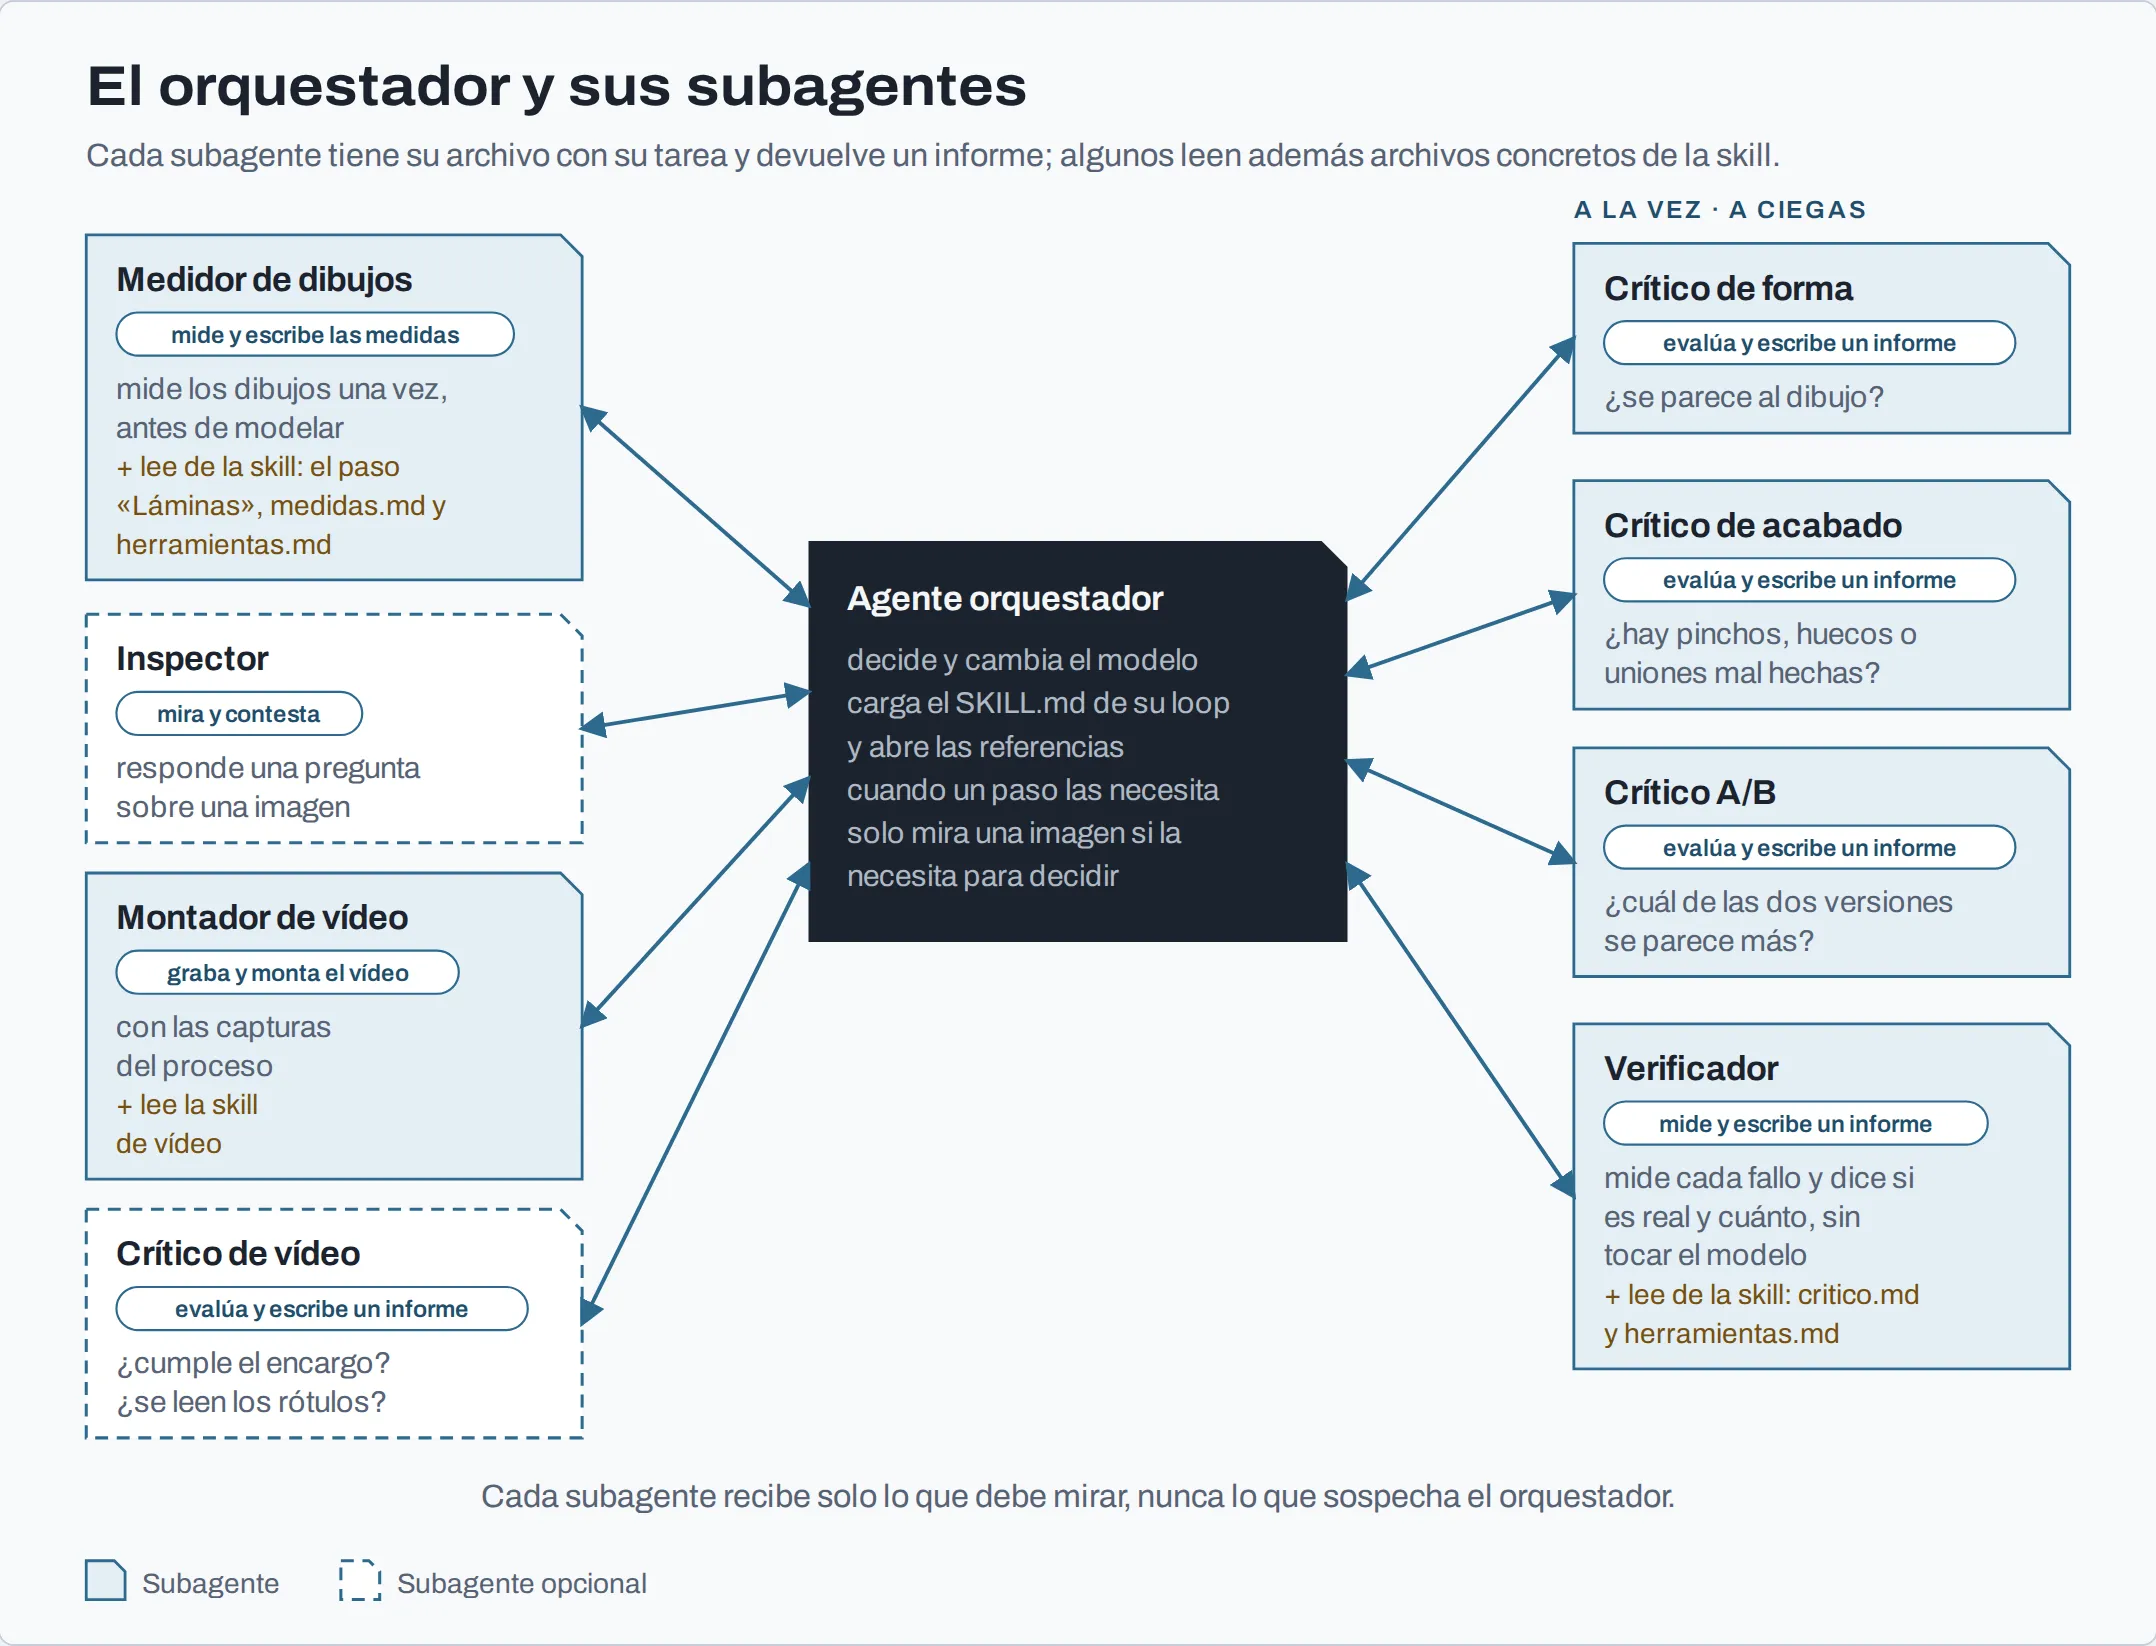
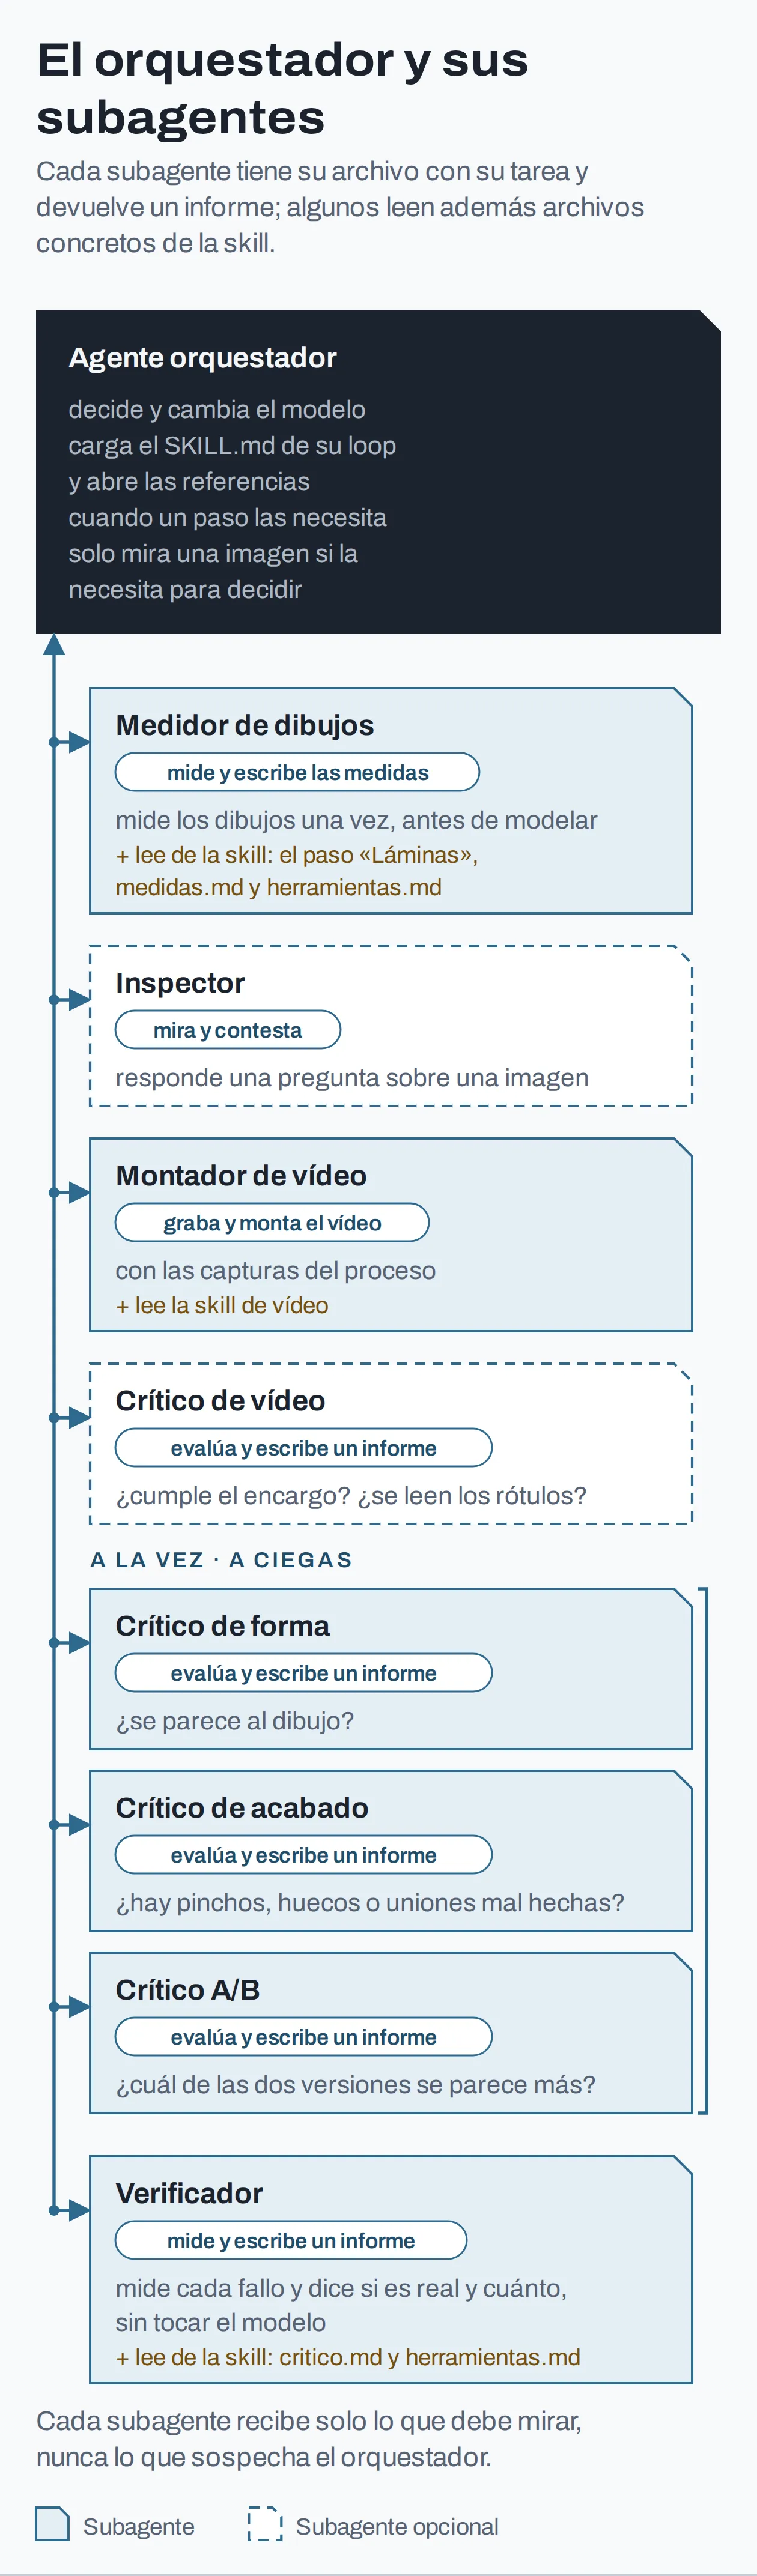 El orquestador y sus subagentes
La skill
La skill de modelado tiene:
SKILL.md, el archivo principal, el que el agente lee al cargar la skill: las reglas del trabajo, las fases del loop en orden, qué subagente entra en cada una y el criterio de terminado.references/, documentos que el orquestador y algunos subagentes consultan solo cuando un paso los necesita:herramientas.md(qué hace cada script),medidas.md(cómo medir lo difícil),critico.md(cómo trabajan los críticos y el formato del registro) ytrampas.md(cada error que costó una ronda, con su síntoma y su arreglo).scripts/, los programas que ejecuta el agente en este loop: miden los dibujos y el modelo, ajustan su geometría, preparan cada revisión y guardan la captura de cada paso. Aquí está buena parte de la potencia del sistema, porque es software de toda la vida: determinista. Hacer el trabajo no gasta tokens, y la misma entrada da siempre el mismo resultado. El modelo decide qué medir; el script mide.
Lo importante es quién carga qué. El contexto de un agente (su memoria de trabajo, todo lo que ha leído y escrito) tiene un límite, y cuanto más se llena, peor trabaja. Decidir qué entra en cada contexto es lo que Anthropic llama context engineering (se abre en una pestaña nueva), y para las skills propone una carga progresiva: el agente lee primero lo mínimo y abre el resto solo cuando lo necesita (Equipping agents for the real world with Agent Skills (se abre en una pestaña nueva)).
En mi caso:
- El agente orquestador carga
SKILL.mdy abre cada referencia solo cuando un paso la necesita. Con una excepción:trampas.mdes obligatorio antes de tocar una sola medida. - Los subagentes críticos y el inspector no cargan nada de la skill, solo su propio archivo. Que miren con ojos limpios es justo lo que les pido.
- El subagente medidor lee el paso de las referencias en
SKILL.md, másmedidas.mdyherramientas.md. - El subagente verificador lee
critico.mdyherramientas.md.
Los scripts de medida y ajuste
Los scripts de verificación son los que hacen posible el loop: convierten un juicio subjetivo («se parece», «está bien») en un número que el agente puede comprobar sin preguntarte. Sin ellos, el evaluador solo puede opinar. Conviene que devuelvan poco texto, porque todo lo que devuelven entra en el contexto del agente.
En mi caso, estos son los más importantes:
compare.py: superpone el modelo al dibujo y saca un mapa de error.segment.py: separa el dibujo por materiales para medirlos uno a uno.planos.py: detecta dónde cambia de plano la superficie.malla.py: evalúa la salud de la malla (pinchos, escalones, asimetrías).revision.py: prepara el material de cada revisión. Deja una lista de imágenes para cada crítico y, para el A/B, pone la versión anterior y la nueva lado a lado en orden al azar, con la clave guardada fuera para que el crítico no sepa cuál es cuál.fit.py: ajusta medidas solo. Prueba valores para las medidas que le indicas (por ejemplo, la posición de un ojo), reconstruye el modelo, mide cuánto se aleja su contorno del dibujo y se queda con los valores que más se acercan.sculpt.py: esculpe la superficie cuando ajustar números no basta.
Lo de devolver poco texto lo aprendí a base de llenar contextos. compare.py ahora imprime solo un resumen y deja el informe entero en un archivo, que se consulta con grep: antes, su salida era la mitad del texto que llenaba el contexto. Y para preguntas como «¿se ve X en esta imagen?», el orquestador pregunta al inspector en vez de leer la imagen él.
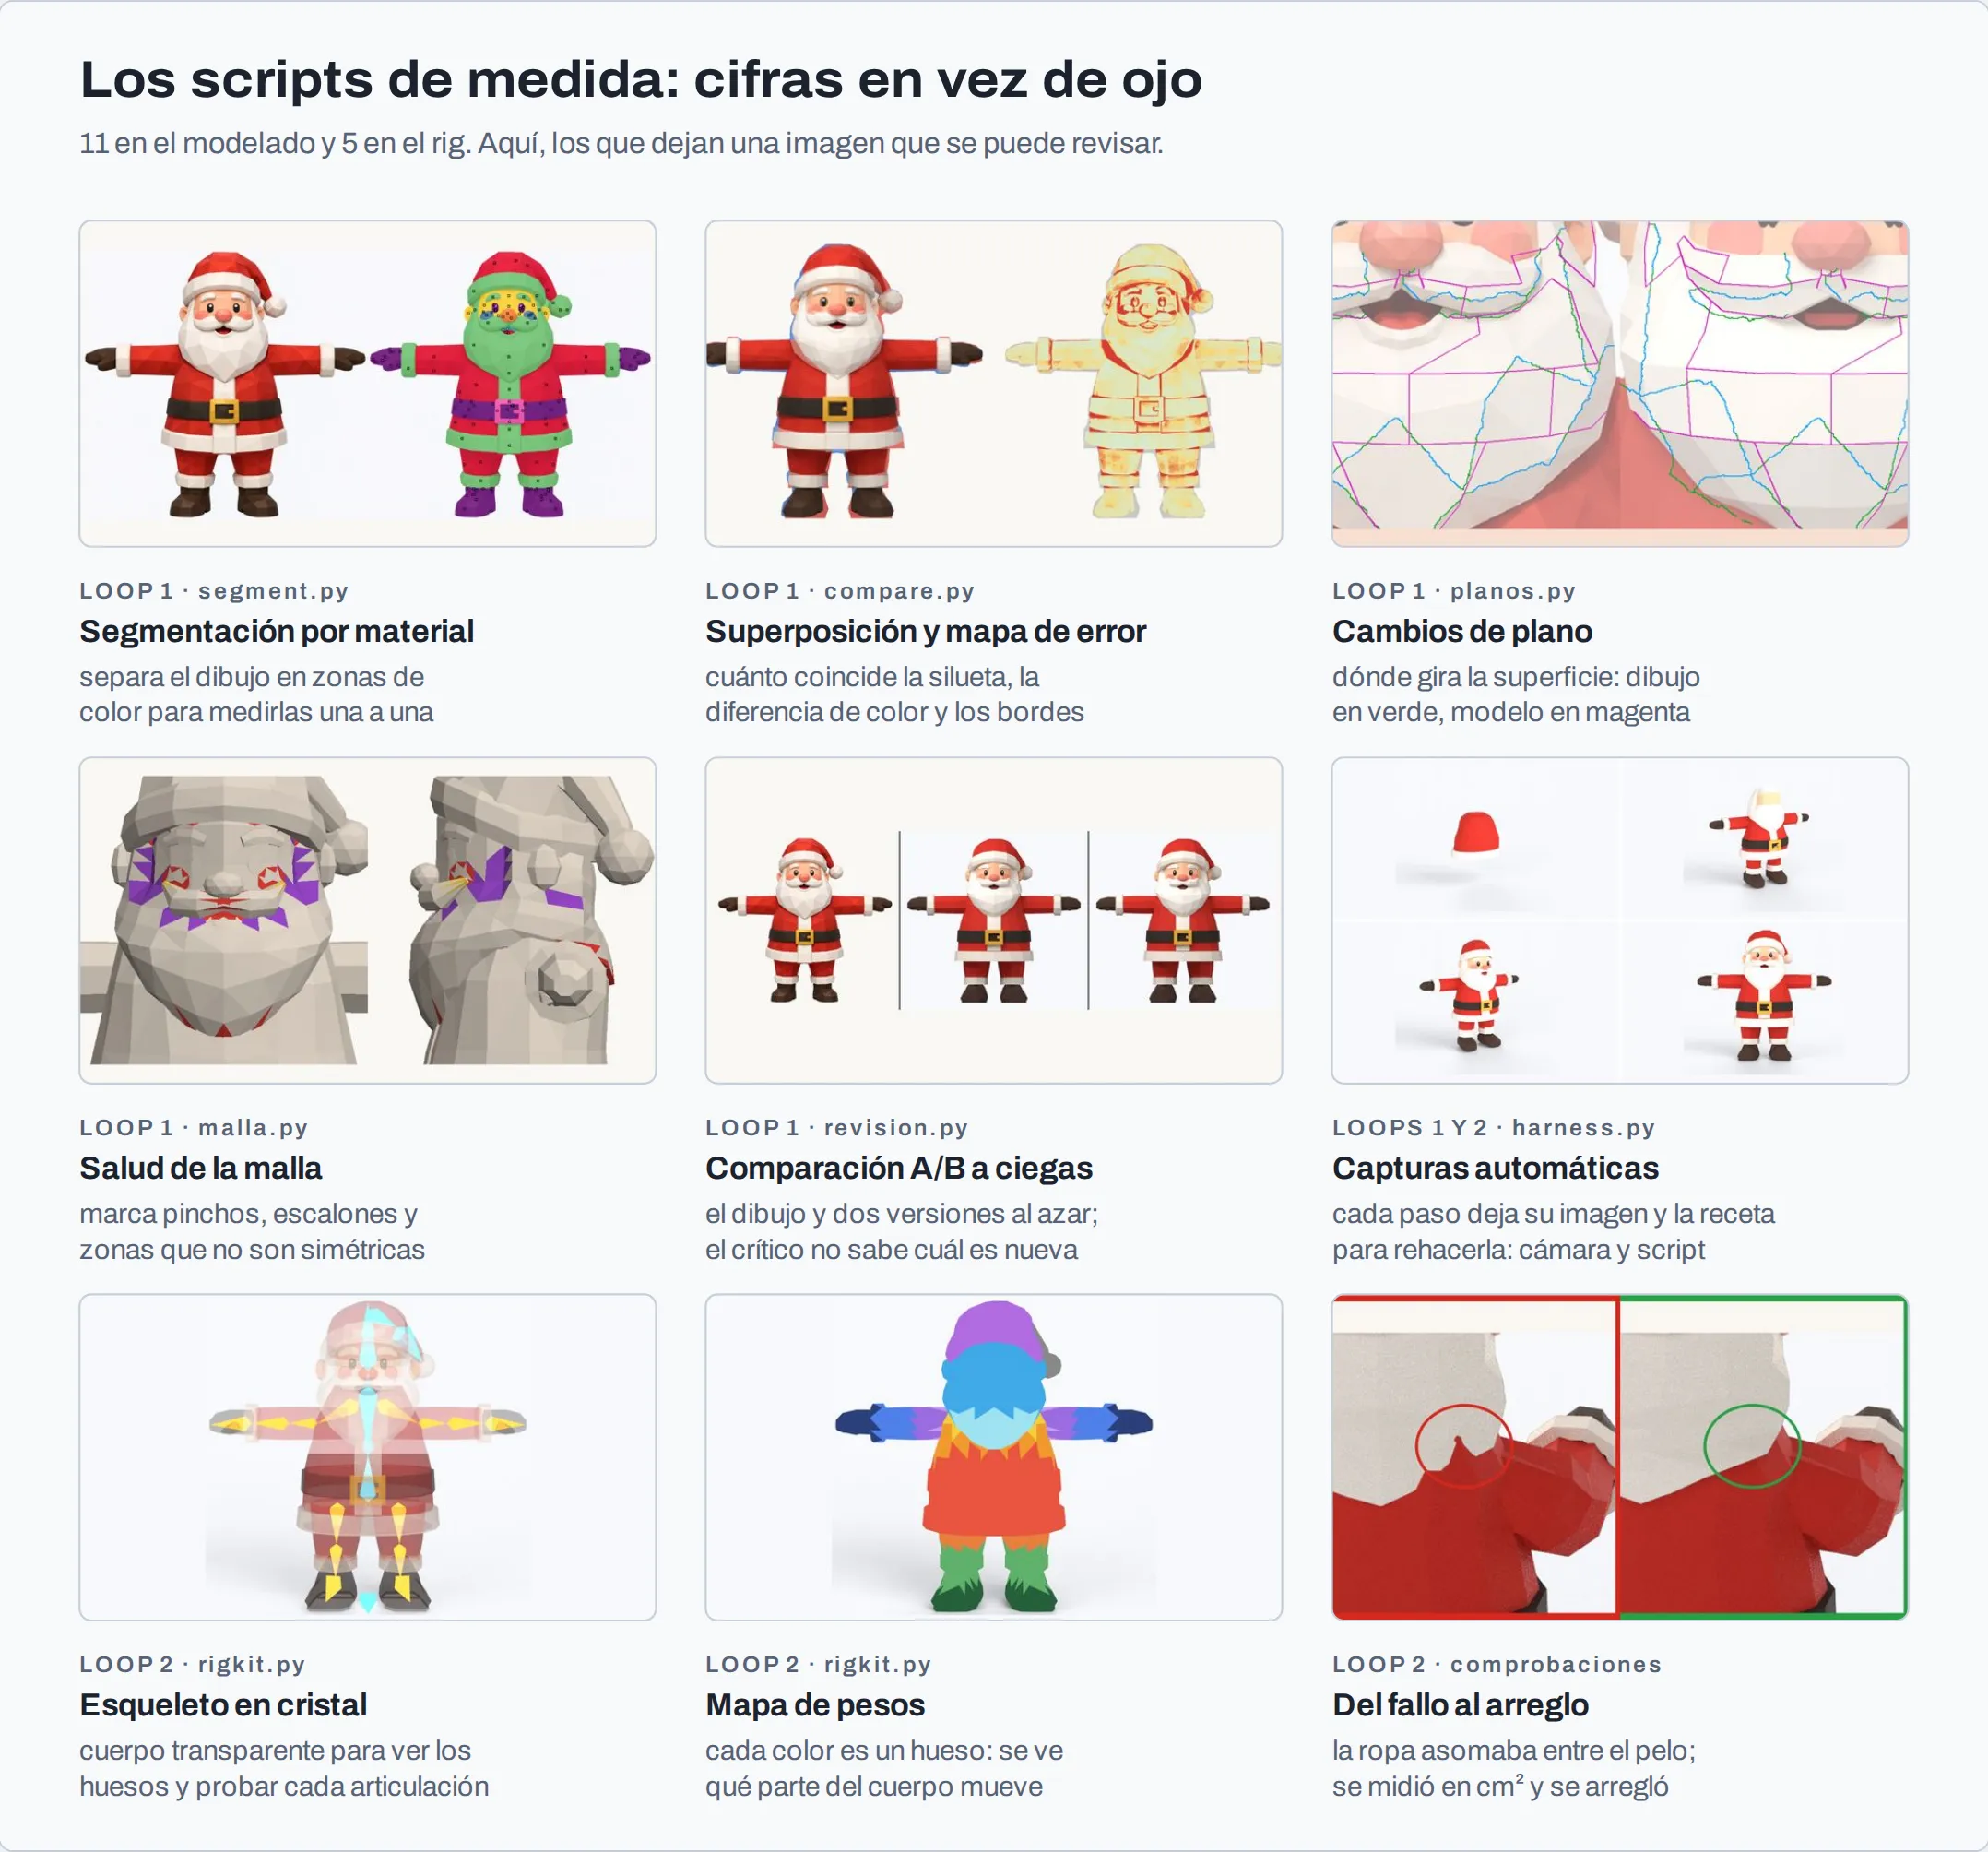
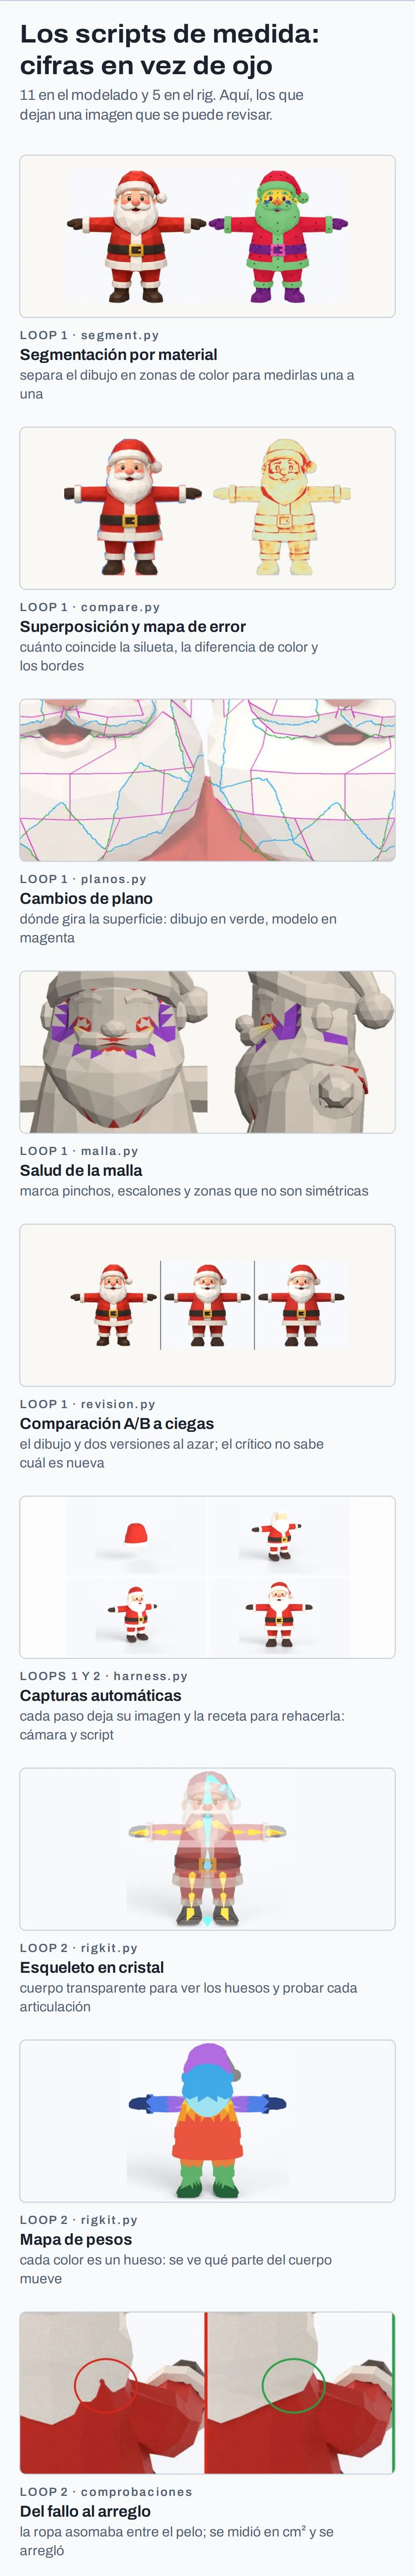 Los scripts de medida de los loops 1 y 2
Cómo es cada vuelta
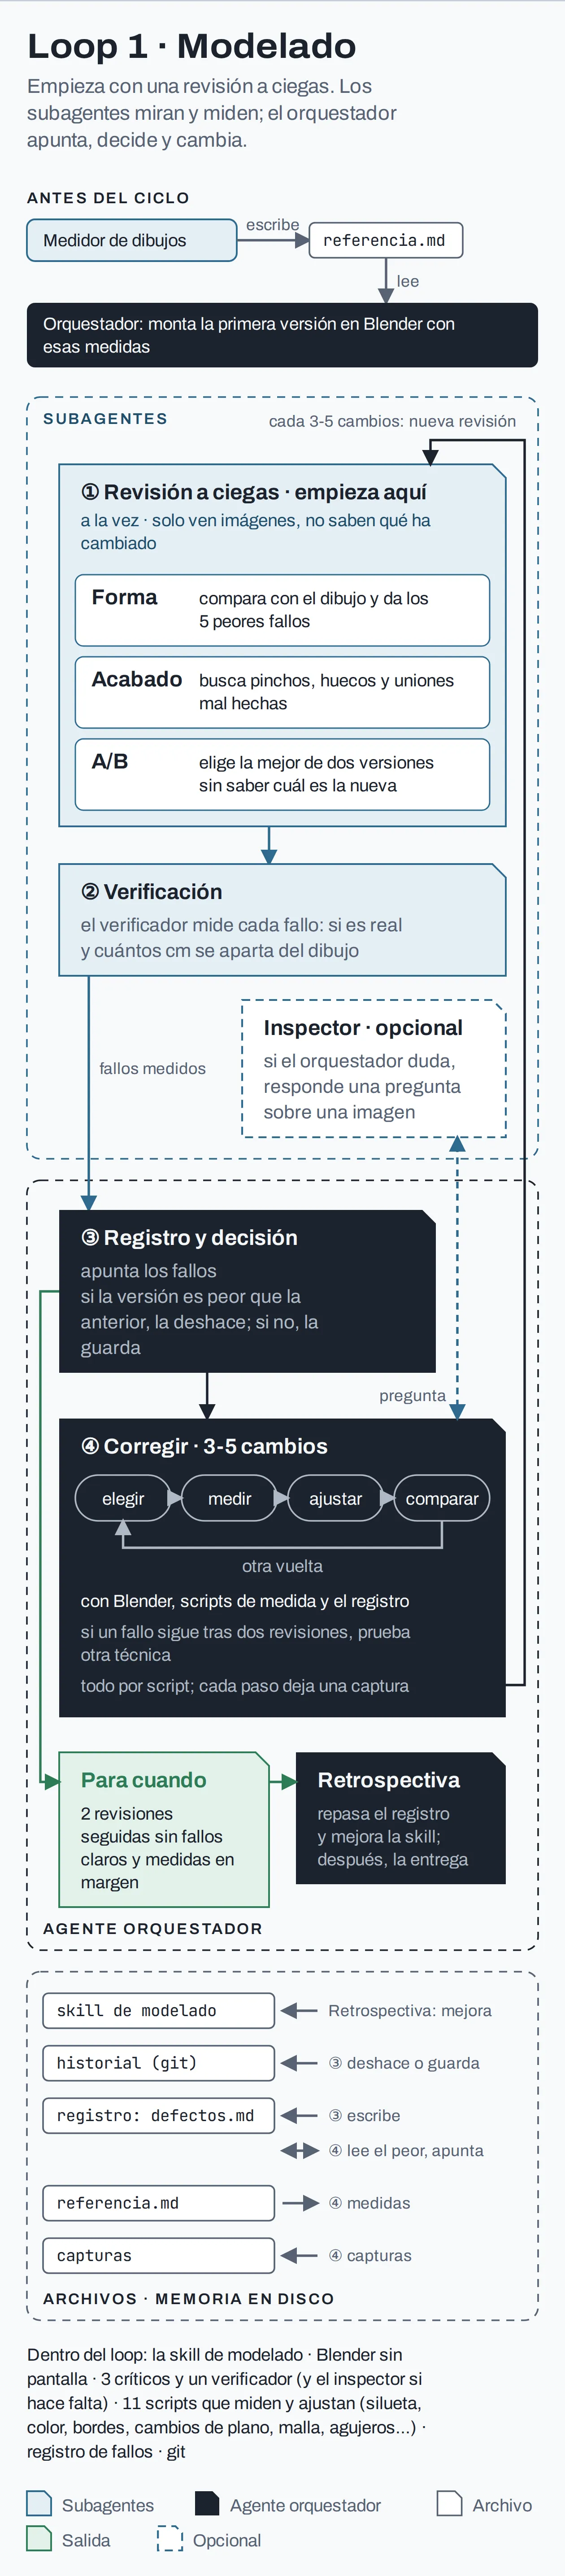
Antes del ciclo, el medidor mide los dibujos (proporciones, colores y desde qué ángulo se dibujó cada uno) y escribe referencia.md. El orquestador lo lee y escribe la primera versión del script.
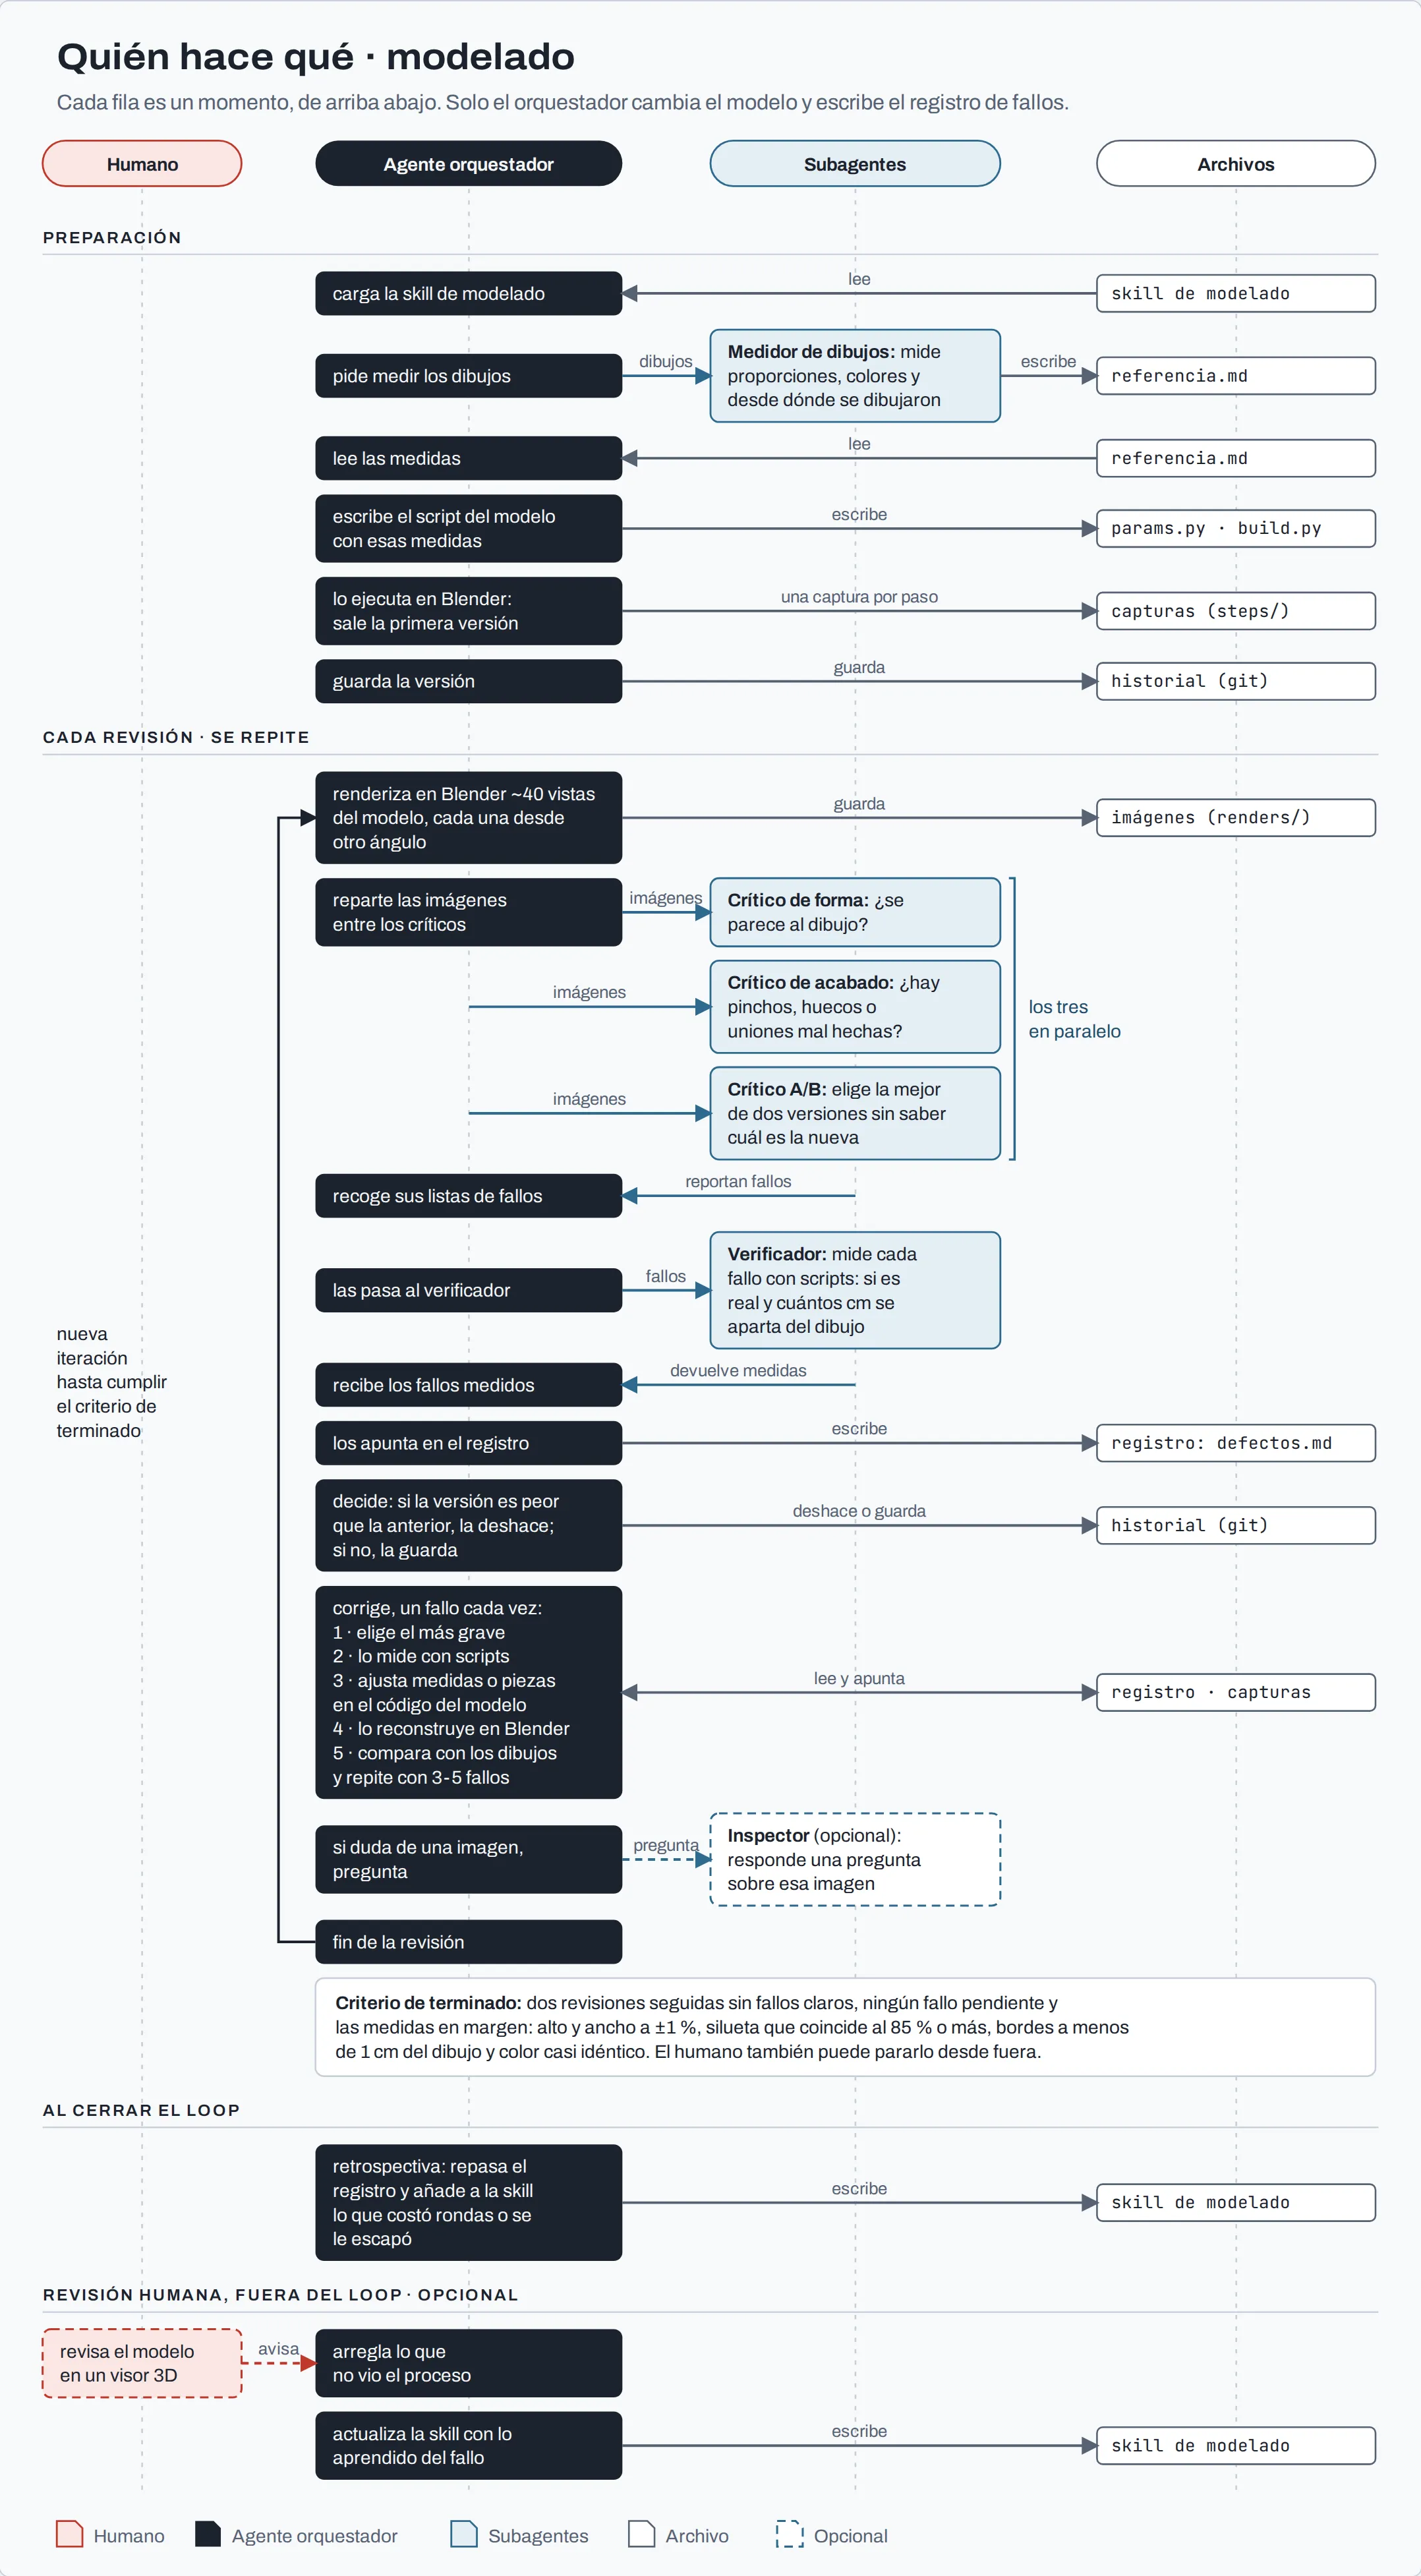
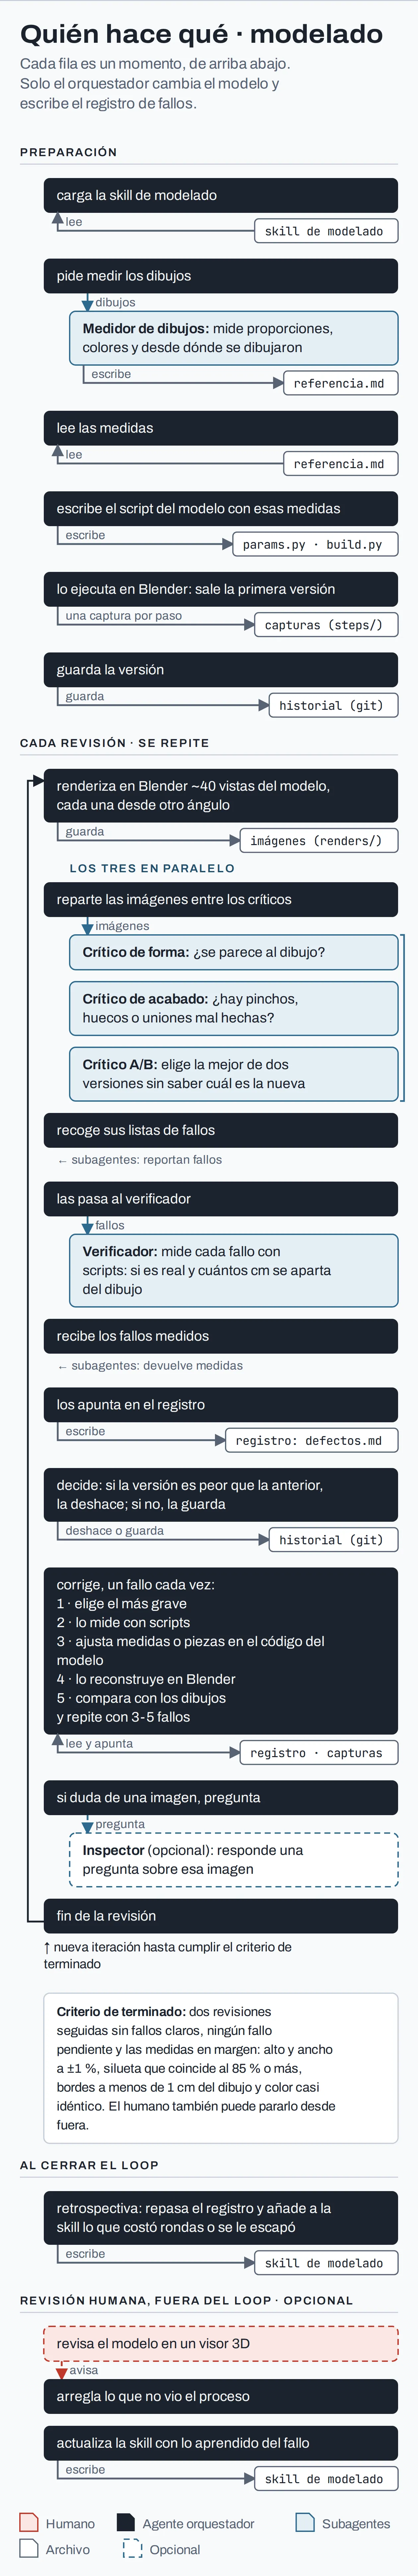 Quién hace qué en el modelado
Cada vuelta tiene cuatro pasos:
- Revisión a ciegas. El orquestador renderiza unas 40 vistas desde ángulos distintos y lanza los tres críticos a la vez. Ninguno sabe qué ha cambiado.
- Verificación. El verificador mide cada fallo: si es real, si viene del dibujo y cuántos centímetros se desvía.
- Registro y A/B. El orquestador apunta cada fallo en
defectos.md. Si la versión nueva pierde el A/B contra la última aceptada, la deshace con git. - Corrección. Coge el fallo más grave y lo trabaja: elegir, medir, ajustar el script, reconstruir y comparar. Hace 3-5 cambios antes de la siguiente revisión.
Cuando un fallo se resiste, el agente cambia de técnica. Si un fallo sigue ahí después de dos revisiones intentándolo de la misma forma, no lo vuelve a intentar igual: pasa a la siguiente técnica de esta lista, cada una más drástica que la anterior:
- Cambiar a mano una medida en
params.py. - Dejar que
fit.pybusque las medidas. - Cambiar la estructura de la malla: más anillos de vértices, o partir la pieza en dos.
- Esculpir la superficie con
sculpt.py. - Rehacer la pieza desde cero.
La razón tras esta estrategia es que hay fallos que no son de medidas sino de estructura: si a la pieza le faltan vértices o tiene la forma equivocada, no se va a arreglar moviendo ligeramente los vértices.
El criterio de terminado requiere que se cumplan todos estos requisitos:
- Dos revisiones seguidas sin fallos claros.
- Ningún fallo abierto en el registro: cada uno arreglado, falso (con la prueba) o aceptado (con la cifra y el motivo).
- Alto y ancho a ±1 %, silueta que coincide al 85 % o más, bordes a menos de 1 cm y color casi idéntico.
Yo también puedo pararlo desde fuera. En el caso de Santa, lo cerré yo mismo, tras 16 revisiones. Probablemente haya que relajar algún umbral, pero prefiero un sistema exigente y pararlo yo a mano antes que lo contrario: que me devuelva algo que no está listo.
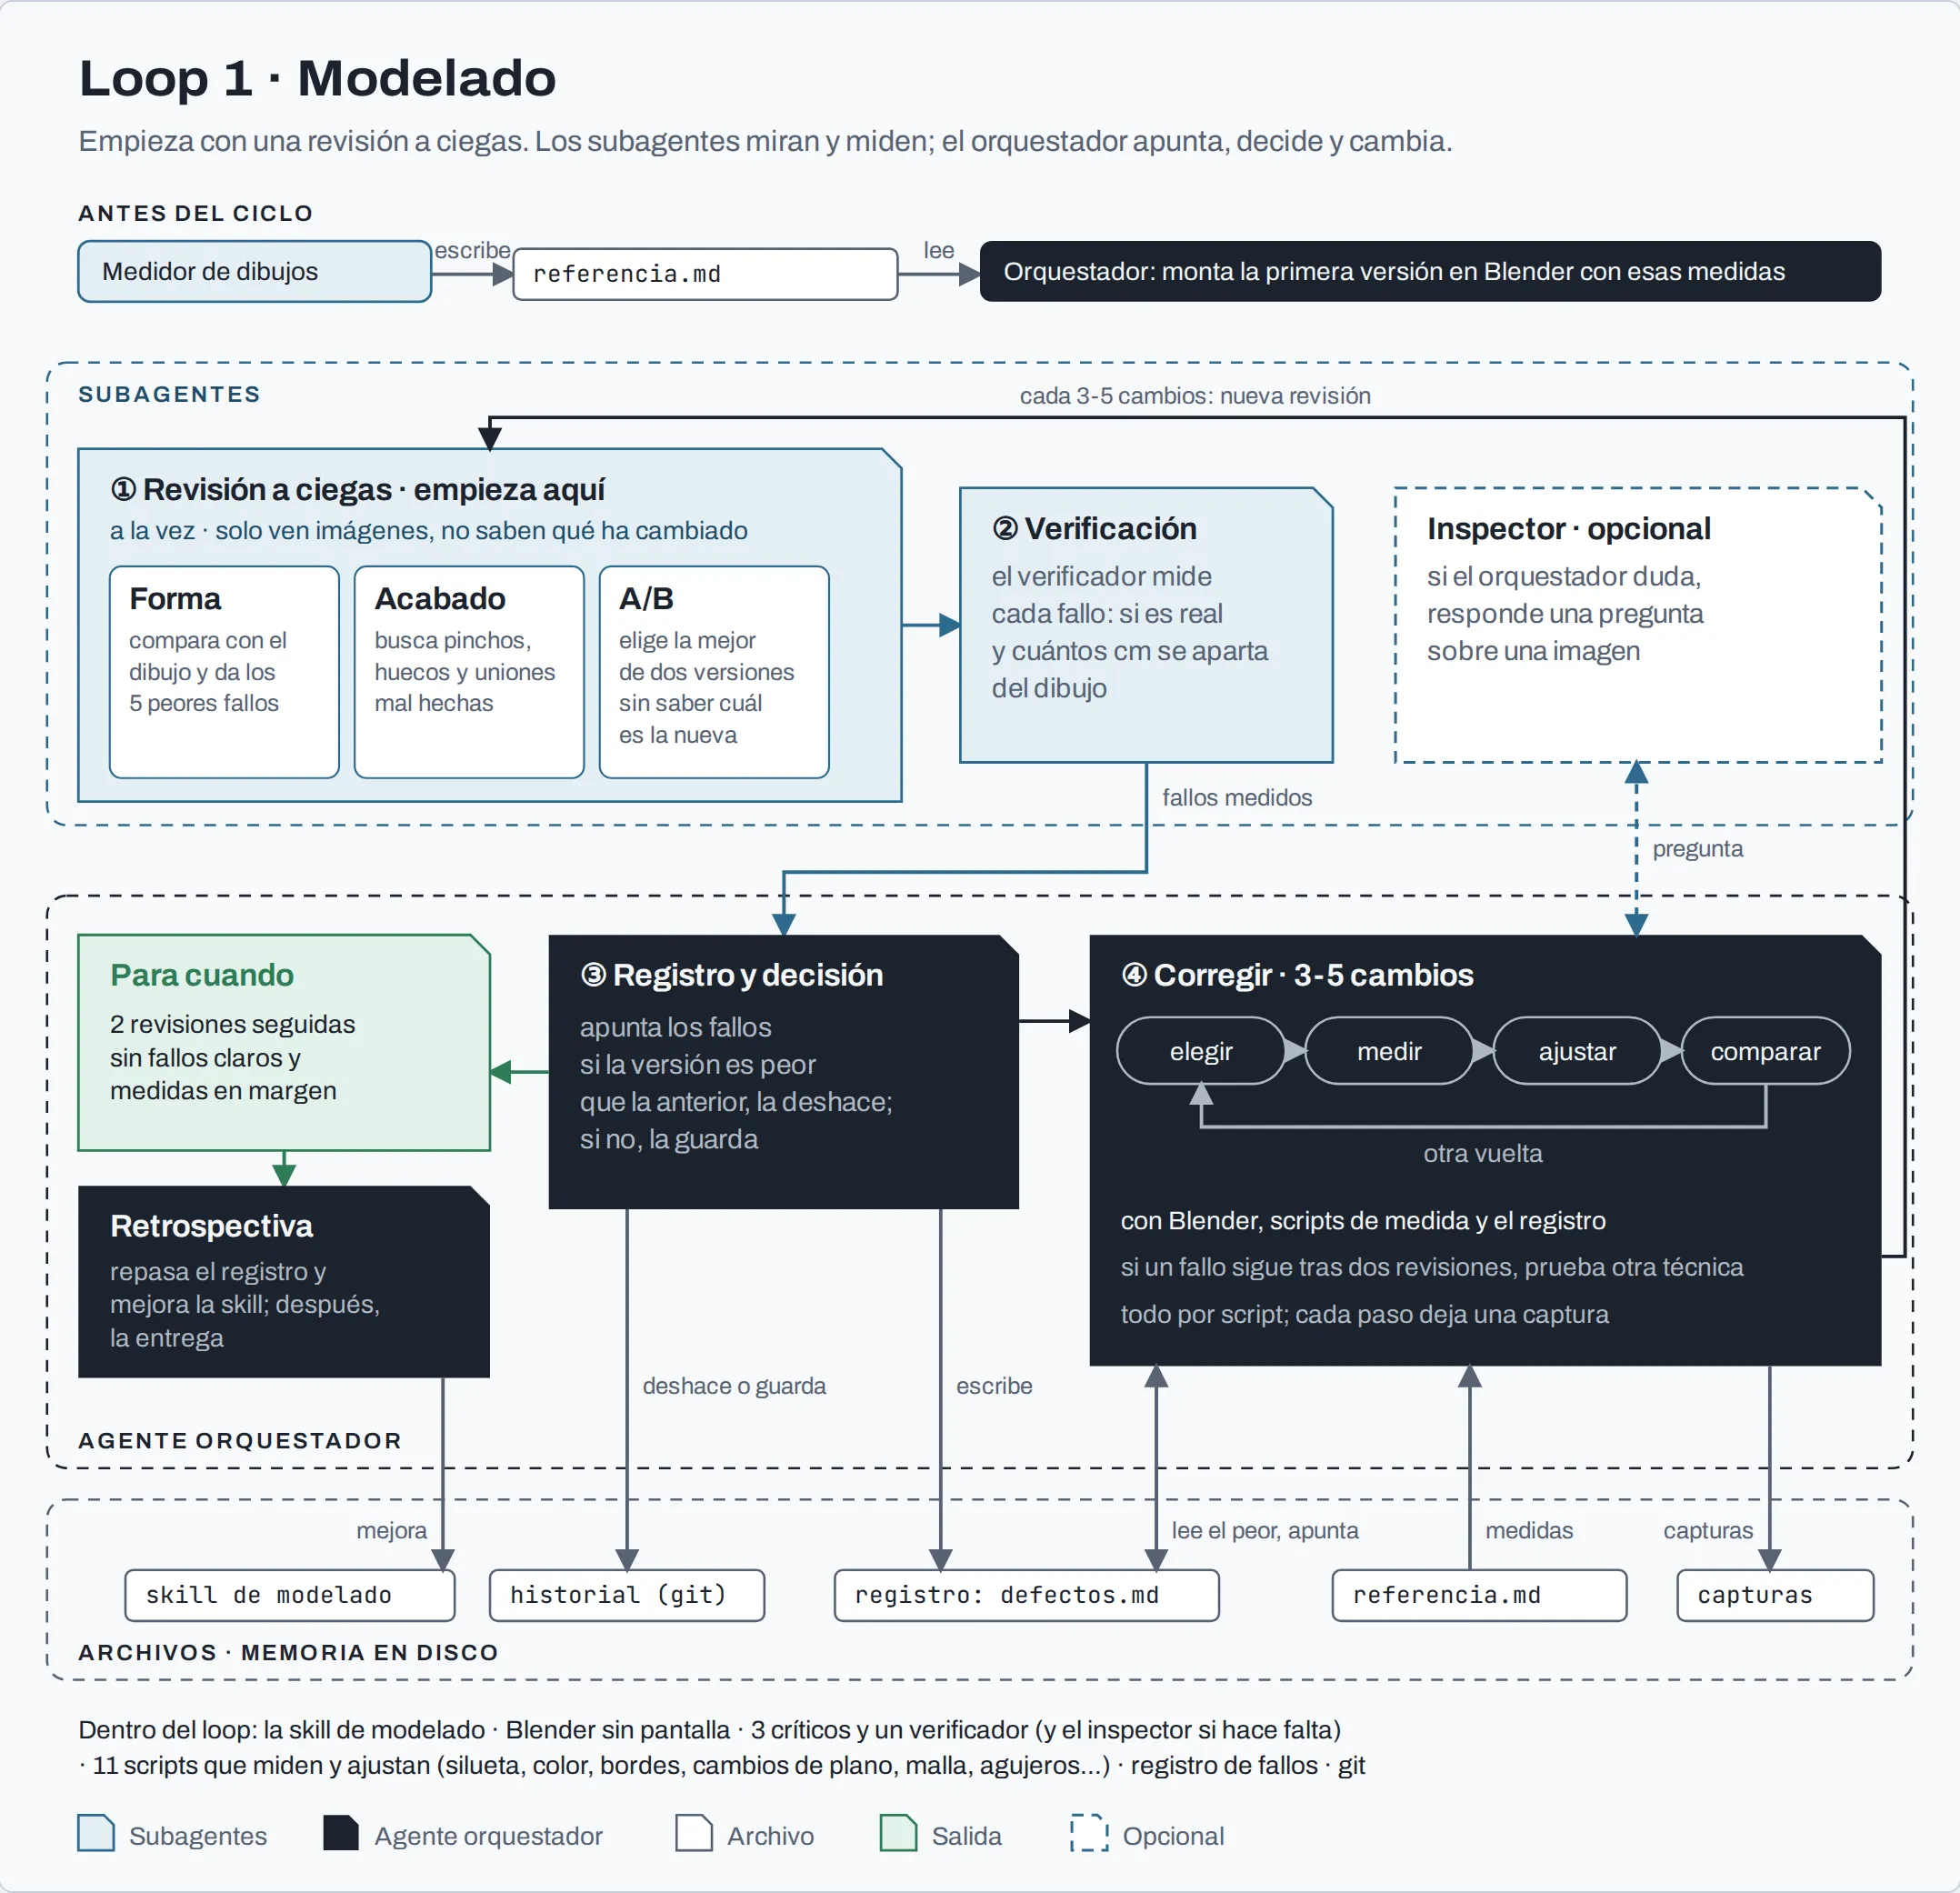
 Loop 1: modelado
Loop 2: esqueleto y animación
Cuando el resultado se puede comprobar con código, el evaluador no tiene por qué ser otro agente. Un script es más barato, más rápido y no se equivoca de la misma forma.
En mi caso, en el loop del esqueleto y la animación hay un solo agente, sin subagentes:
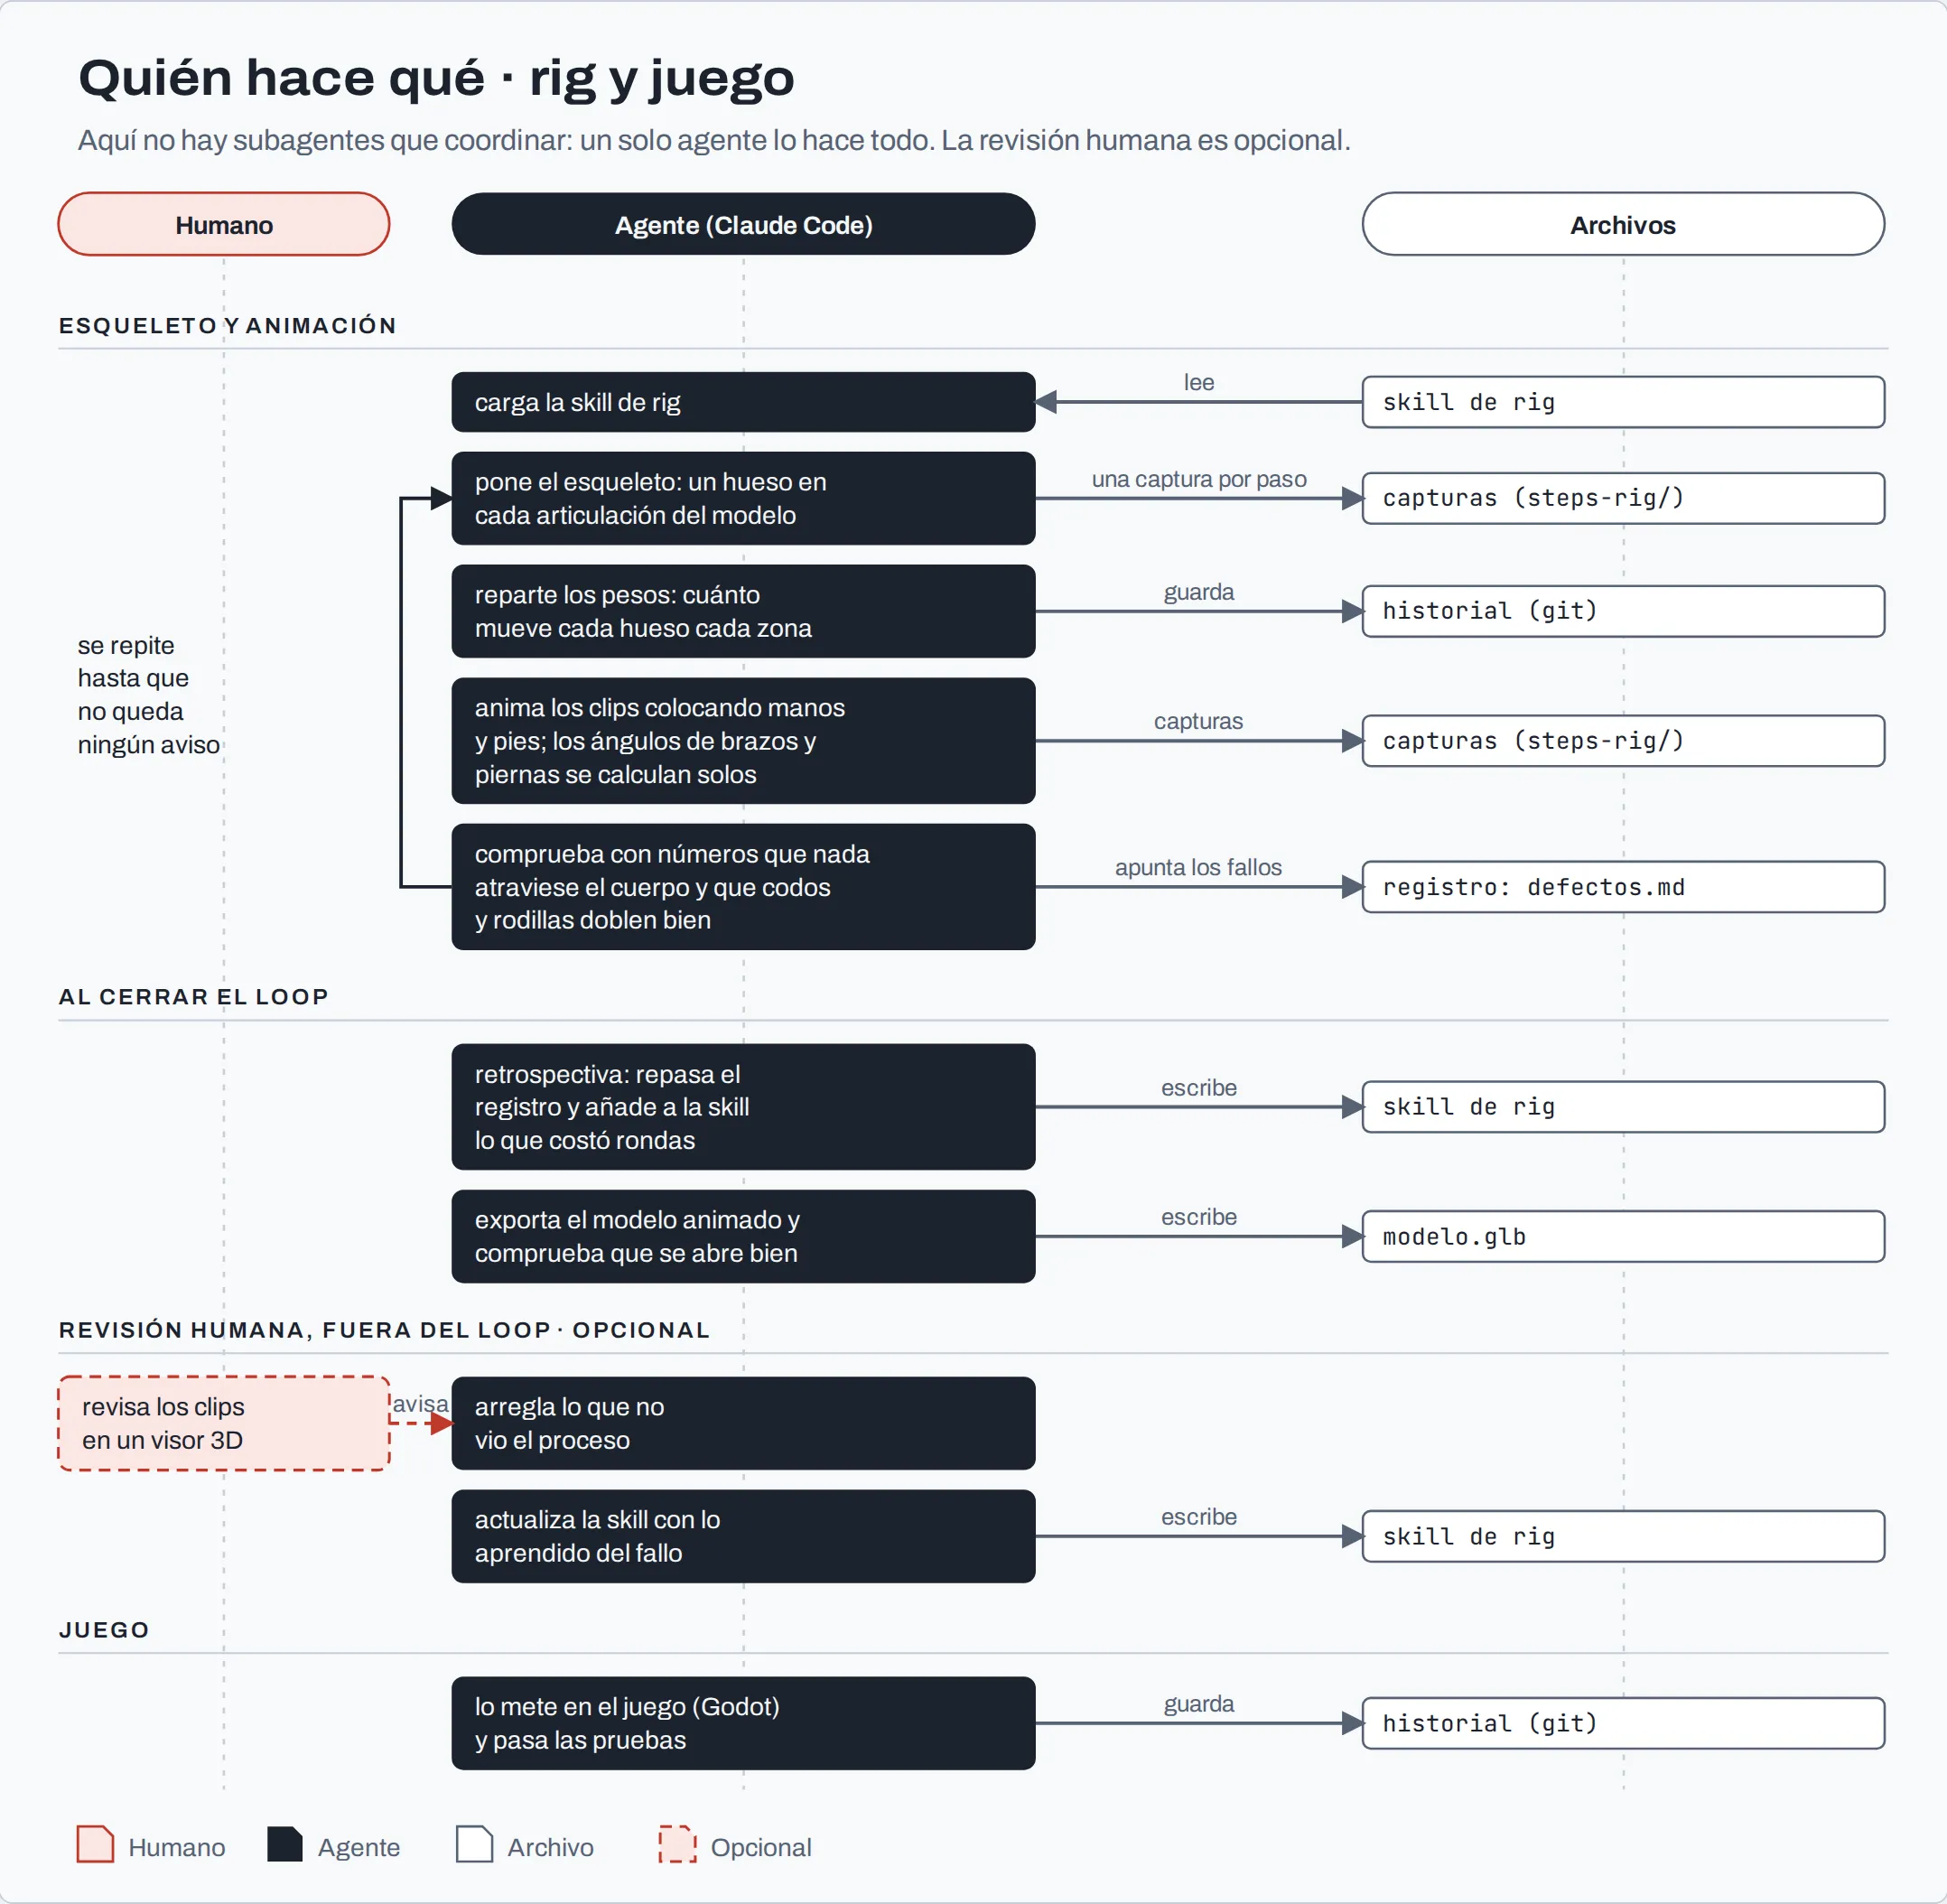
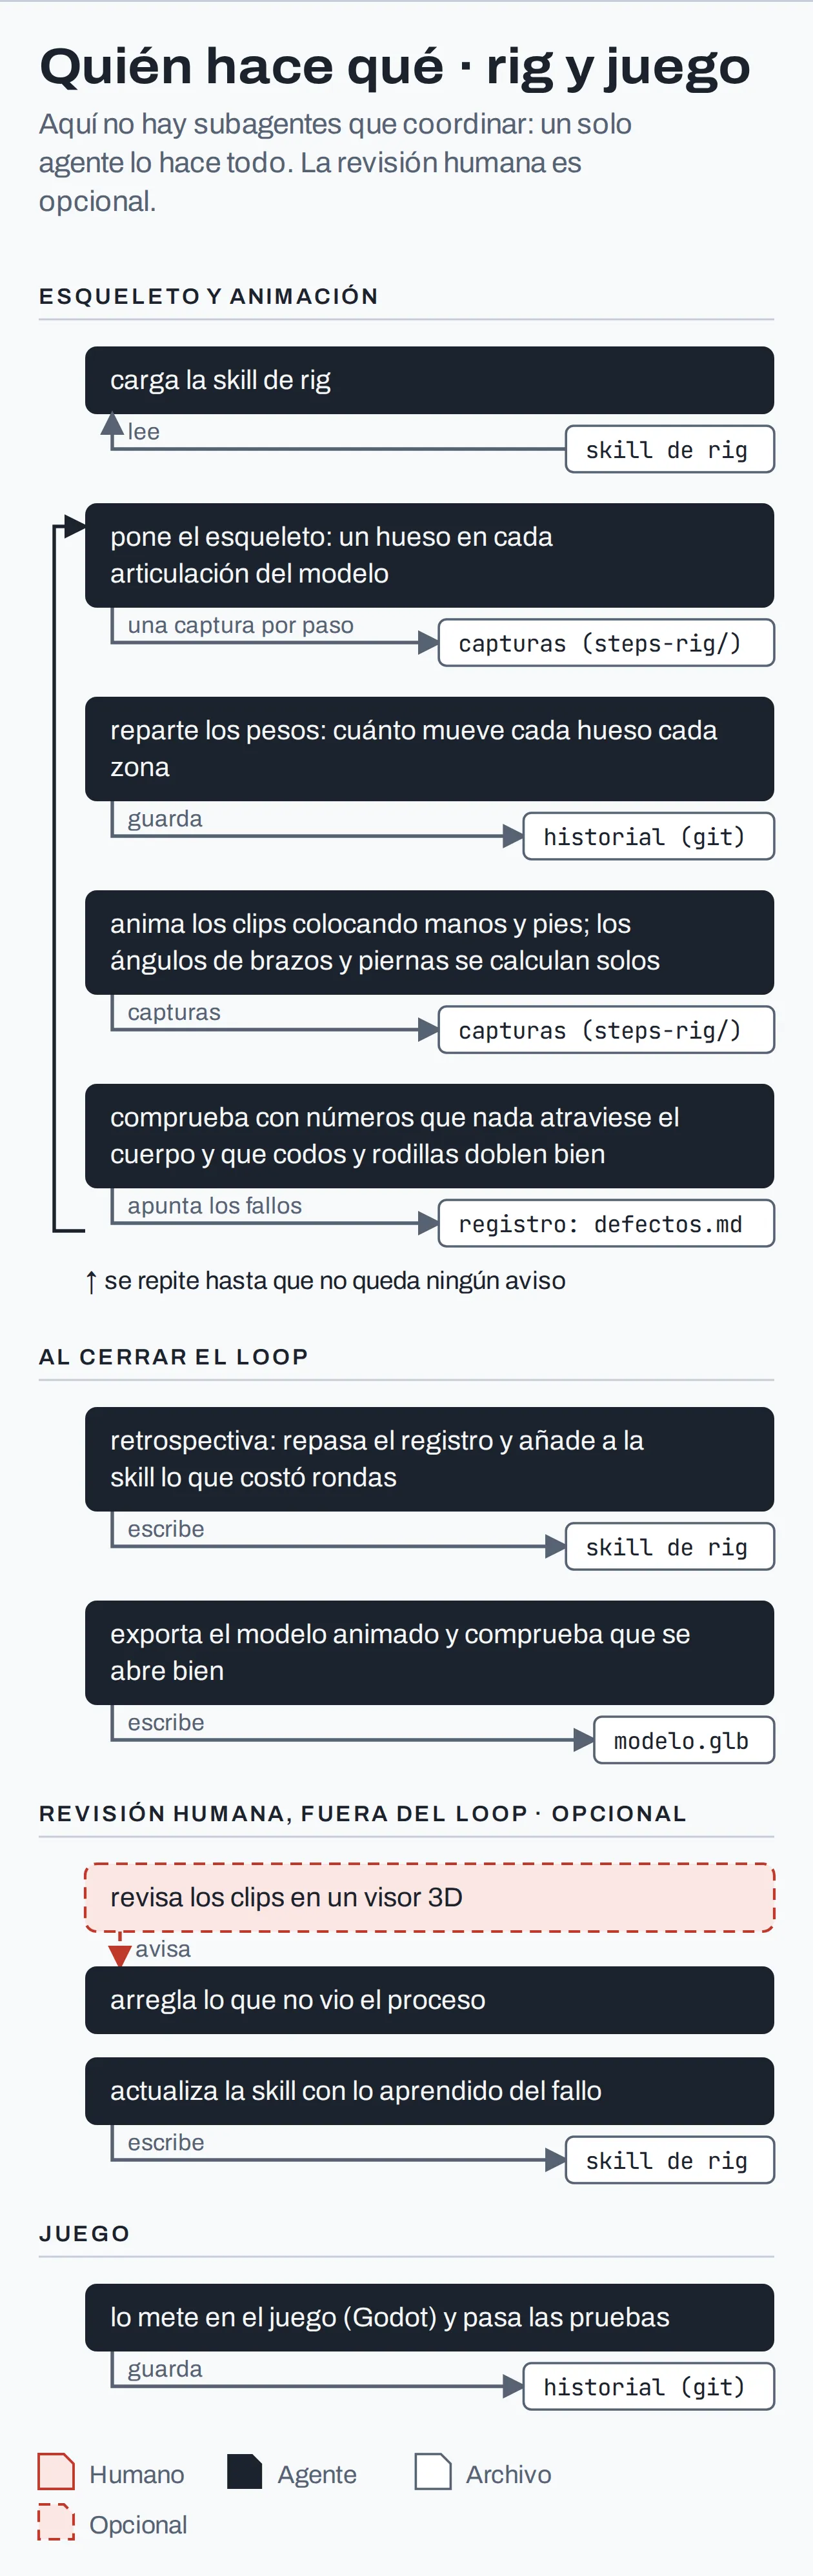
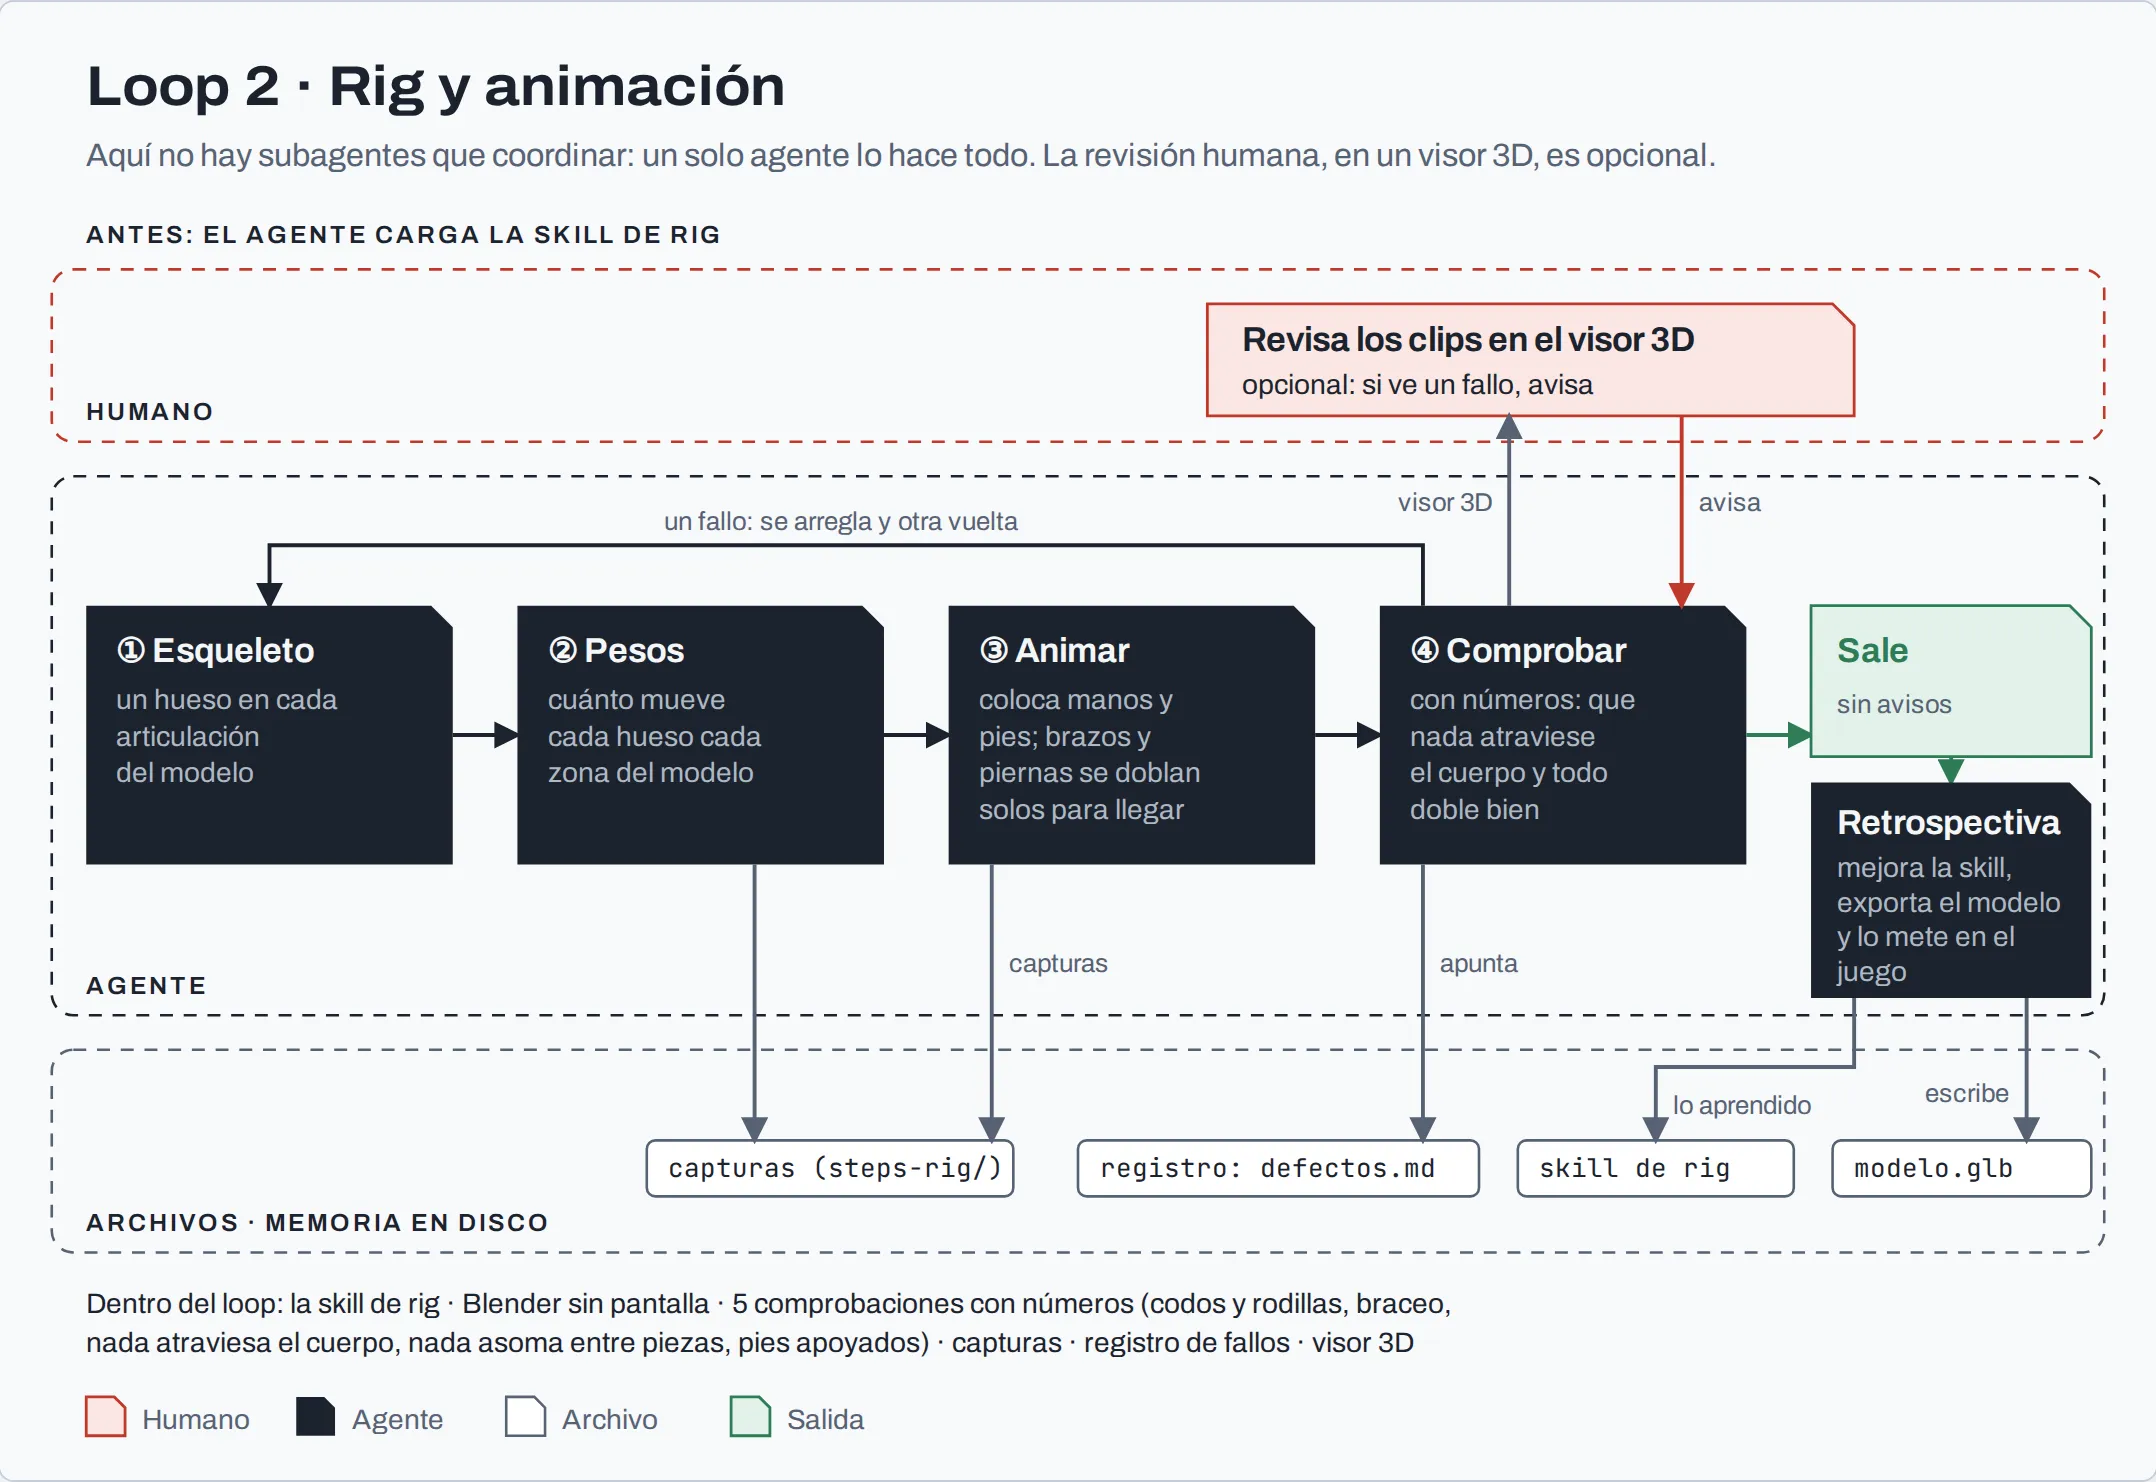
- El agente carga la skill, pone el esqueleto, reparte los pesos (cuánto mueve cada hueso cada zona del modelo), anima los clips y lo comprueba con números. Repite hasta que no queda ningún aviso.
- La skill de rigging es más sencilla que la de modelado: su
SKILL.md, sustrampas.mdy una librería,rigkit.py. - Los scripts son cinco comprobaciones con código: que codos y rodillas doblen hacia su lado, que los brazos se balanceen hacia delante y atrás (no de lado), que nada atraviese el cuerpo, que no asome ropa entre piezas y que los pies apoyen sin hundirse.
Por eso este loop sale mucho más barato: 30 $ frente a los 151 $ del modelado.
 Quién hace qué en el rig y el juego
Al terminar, exporta el modelo (modelo.glb) y lo mete en el juego, en Godot, con sus pruebas.
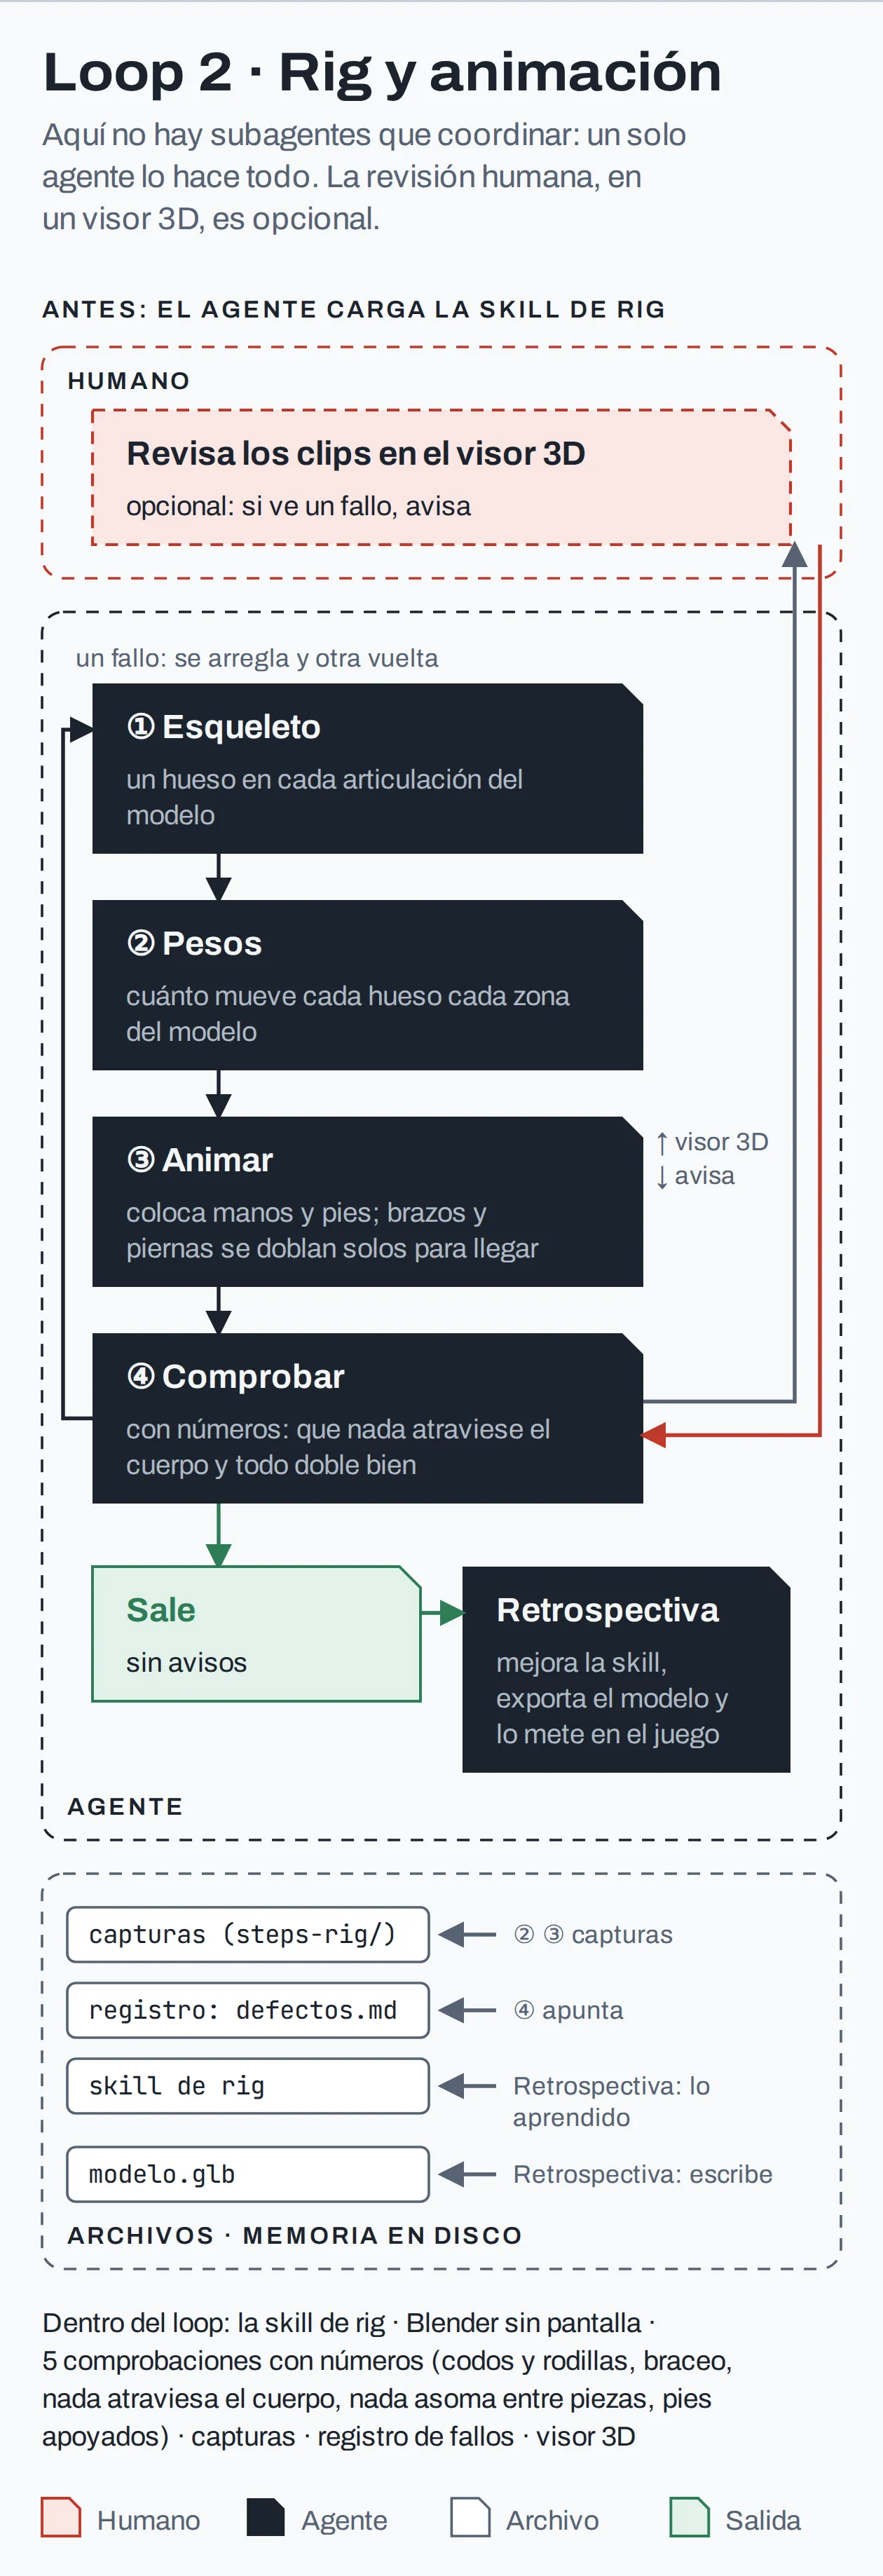 Loop 2: esqueleto y animación
Loop 3: vídeo (opcional)
Un loop no tiene por qué producir el resultado principal. También sirve para tareas de apoyo, como documentar o enseñar el trabajo, con su propio encargo y su propio evaluador.
En mi caso, el tercer loop monta un vídeo del proceso. No hace falta para el juego, pero sí para enseñarlo:
- Los agentes: el orquestador da un encargo (duración, idioma de los rótulos, cómo abre y cómo cierra, y para quién es) y lo reparte entre dos subagentes con Sonnet 5.5. El montador graba una vuelta de 360° al modelo y un fundido al dibujo frontal, y monta las capturas de cada paso sin los intentos que se deshicieron. El crítico de vídeo lo revisa contra el encargo.
- La skill: la skill de vídeo, con las instrucciones del montaje (qué grabar, cómo montarlo y cuándo llamar al montador y al crítico) y sus scripts.
- Los scripts:
video.pymonta el vídeo ycheck_video.pylo decodifica para cazar fotogramas en negro.pasada.pyhace el fundido del modelo al dibujo, yreplay.pyvuelve a renderizar las capturas en más calidad a partir de su receta. Y como el crítico no puede ver vídeo,hojas_video.pyle saca un fotograma cada 1,5 s con su segundo debajo. Así puede decir dónde está cada fallo.
Si el crítico encuentra fallos, el montador vuelve a montar el vídeo y el crítico lo revisa otra vez, hasta que lo da por bueno.
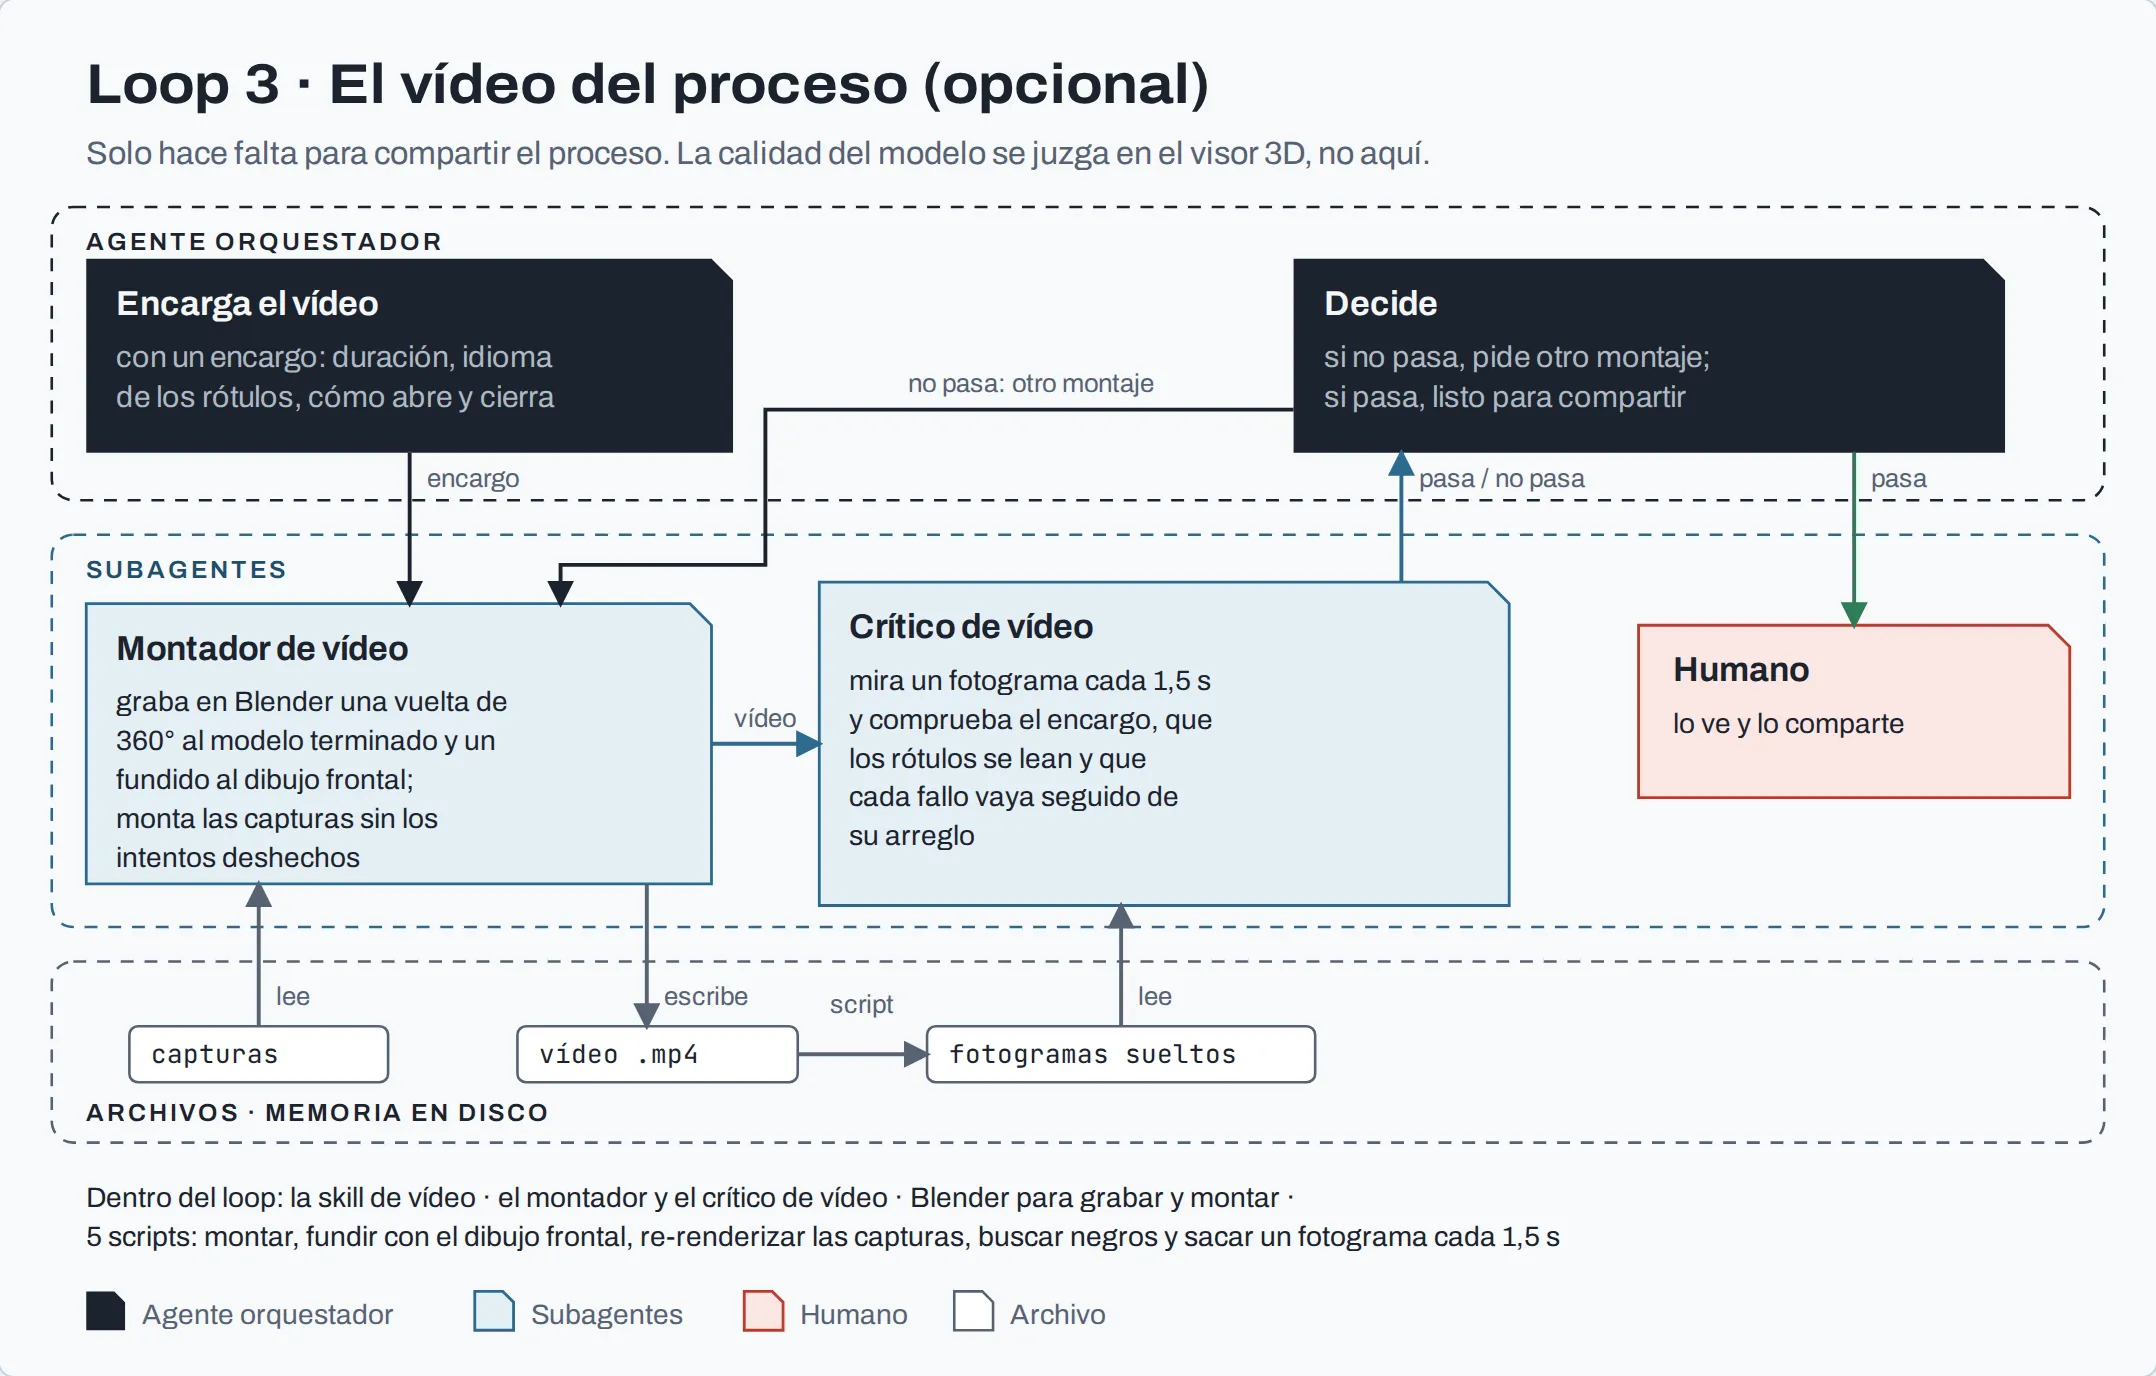
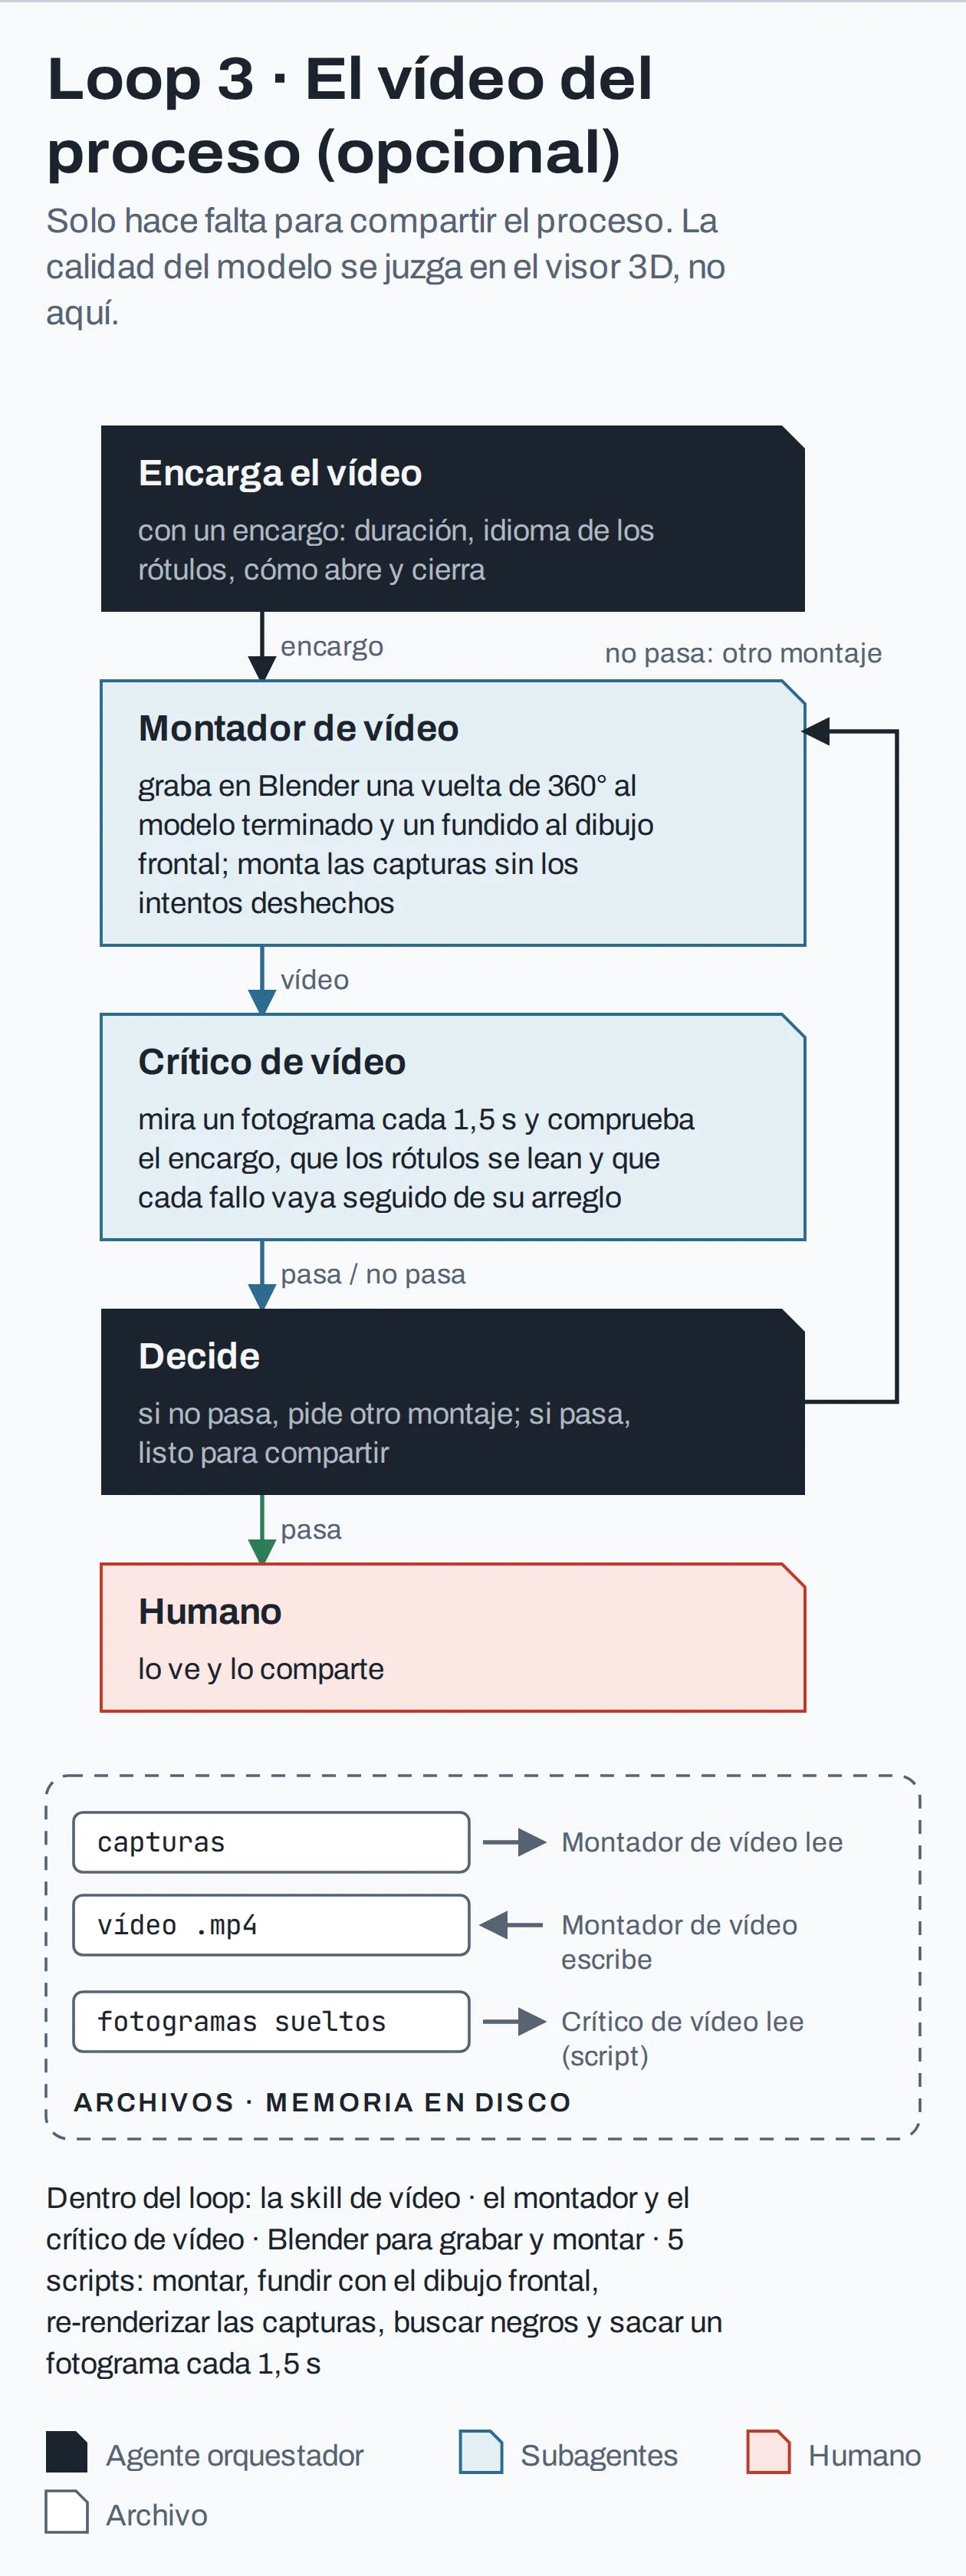 Loop 3: vídeo
Lo que comparten los tres loops
La memoria vive en disco
Cuando la memoria de un agente se llena, Claude Code la resume para seguir trabajando, y en ese resumen se pierden detalles. Anthropic propone guardar el progreso en un archivo y apoyarse en git (Effective harnesses for long-running agents (se abre en una pestaña nueva)).
En mi caso, el registro de fallos, las medidas y las capturas viven en el repositorio, junto al historial de git. Cuando el contexto se resume, el trabajo sigue donde estaba, porque lo importante no solo se guarda en la memoria del agente, sino también en los archivos de trabajo.
Sistemas que aprenden solos
Un loop puede mejorar sus propias instrucciones: al terminar, repasa qué le ha costado y lo convierte en reglas para la próxima vez.
En mi caso, al cerrar cada loop el agente repasa el registro y busca:
- Fallos que han sobrevivido a dos revisiones o más.
- Fallos que los críticos no han visto.
- Falsas alarmas que han costado rondas.
- Los pasos más lentos.
Es el propio agente quien, en esa retrospectiva, actualiza la skill: añade una lección a trampas.md, una comprobación nueva al script que no ha cazado el fallo o una línea al archivo del subagente que se ha equivocado, citando siempre el fallo que lo ha motivado. Se hace al final del loop y no en cada vuelta, para no estar cambiando las reglas a mitad de partido.
Después viene mi revisión, opcional, en un visor 3D. Si encuentro algo, se arregla dos veces: en el modelo y en la skill.
Un ejemplo: en la imagen lateral, la perspectiva pintaba los brazos más atrás de lo que estaban. El agente los colocó ahí y sus medidas lo daban por bueno, pero en el visor 3D vi en un segundo que salían por detrás del torso. Ahora es una regla de la skill.
Lecciones aprendidas
El sistema no es perfecto, y he tenido que mejorar el pipeline varias veces. Antes de Santa lo probé con otros personajes, y de ahí salieron unas cuantas lecciones:
- Un solo agente se satura. Con todo el trabajo en una misma conversación, su memoria se llenaba de imágenes, salidas de scripts y código. Al repartirlo en subagentes, funciona mucho mejor.
- Los críticos también se equivocan. En una revisión, un tercio de los fallos que señalaron eran falsos. Por eso, ahora no se arregla nada sin que el verificador lo haya confirmado antes.
- Lo barato puede salir caro. Con un modelo más barato, el crítico de acabado encontraba la mitad de los fallos.
- Mejorar las cifras no basta. Hubo vueltas en las que todas las medidas mejoraban, pero al mirar el personaje entero estaba peor que antes. Por eso añadí la comparación A/B a ciegas entre la versión nueva y la anterior.
- Las referencias también fallan. Las imágenes hechas con IA no coinciden del todo entre sí, así que hay que decidir cuál manda en cada medida.
Lo que todavía no hace mi pipeline
- En el modelado, el orquestador también construye. Un subagente modelador lo dejaría solo coordinando, que es lo suyo.
- El criterio de terminado no siempre se alcanza solo.
- Mi revisión todavía encuentra cosas, aunque cada vez menos.
Mi opinión personal
Los patrones de Anthropic te dicen cómo organizar los agentes, pero no qué tienen que revisar ni cómo se mide. Eso solo lo sabes después de haberte peleado con el problema.
No puedes automatizar un trabajo que no sabes hacer. Mis primeros modelos los hice usando la IA de forma mucho más rudimentaria: Claude modelaba en Blender y yo revisaba cada resultado y le pedía cambios (lo conté en cómo modelar un personaje 3D con IA). Era lento, pero me sirvió para entender el proceso, detectar los puntos críticos y adquirir todo el conocimiento que ahora he trasladado a mi fábrica. De ahí salió, por ejemplo, la idea de que el modelo fuera un script de Python, o los distintos scripts para medir el resultado en vez de discutirlo a ojo.
Y una cosa más: no te desesperes si al principio tu loop no es tan útil como esperabas. No vale con decirle «hey Claude, create a 3D model factory, make no mistakes». Automatizar un proceso con IA es un trabajo iterativo: lo diseñas, lo pruebas, ves dónde falla y le pides a la IA que lo arregle. Y vuelta a empezar, hasta que en algún momento tu pipeline haya mejorado lo suficiente como para dejar de necesitarte.
¿Te ha gustado este artículo? No te cortes, déjame un comentario y ayúdame a compartirlo 😉
Recibe los artículos nuevos por correo
Un correo cuando publico algo nuevo. Sin spam, y te das de baja con un clic.
Casi está: te he enviado un correo. Pulsa el enlace que lleva para confirmar.
Algo ha fallado. Prueba otra vez en unos minutos.
Comentarios
Para comentar necesitas una cuenta de GitHub.